
ムエタイ · バランス · PPO
ムエタイの構えでバランスを学ぶ
学習コスト 約$23学習ラン19回、約29.8マシン時間 · 内訳
その他の動画

概要。 物理シミュレーション上の人型(身長1.75 m、体重77 kg)に、ムエタイの構えで立ち、押されてもバランスを保つことを学習させます。目標はすべてムエタイのコーチが設定し、結果もすべてコーチが目で見て判断しました。まず、手本となる構えとリズムを運動学的に解きます。次にPPOの方策(ポリシー)が、位置サーボへの残差補正として、それを追従することを学びます。バランスゲート、適応型の行動フィルタ、滑らかさの報酬、そしてフォームの床によって、関節のジッターは関節1つ・1秒あたりの方向反転1.7回から0.01回に減りました。続いて、コーチが生徒を押すようにファイターを押します。立て直しの方法を2つ試します。1つ目では、ファイターは手で設計した立て直しの動き(カウンターウェイトの脚を使った横へのホップと、前後へのステップ)に従います。600 Nの押しまで到達しますが、固定テストでは12回中3回倒れます。2つ目では、バランスを崩したら脚と体幹は自由に動いてよく、ガードは上げたままでなければならず、報酬は立っていることだけです。この方策は860 Nの押しに耐え、600 Nと860 Nの固定テストでは12回中0回の転倒、8方向の統制テストでは16回の押しすべてに耐えました。よりシンプルな体でゼロから学習させると、同じタスクがクラウドマシン1台で約40分で最大の力に到達し、1回のランの費用は約$1.50でした。
1. なぜ構えから始めるのか
ムエタイでは、ほとんどの打撃系格闘技と同じく、すべては構えから生まれます。蹴りもパンチもチェックも、構えから始まり構えに戻ります。押されて構えを崩されるファイターは、攻撃も防御もできません。ですから構えは、シミュレーションのファイターが最初に学ぶものであり、バランスは最初にテストするものです。
コーチは筆者であり、ムエタイを教えているヤム トニーです。ここでのすべてのステップは、コーチが生徒を見るのと同じ基準、つまり「正しく見えるか?」で判断しました。報酬関数ではそれを測れません。そのため、学習はもともとヒューマン・イン・ザ・ループとして設計されています。コーチが構えと動きを指定しました。進捗の動画を見て、おかしく見える動きを却下し(点数は高いのにおかしく見える結果がいくつかありました)、次に何を試すかを選びました。その判断から生まれた決定は第9節にまとめています。
唯一正しいムエタイの構えというものはありません。ガードにもいろいろあり(ロングガード、ハイガード)、両足への体重の配分もさまざまです。ここでの構えは後ろ足により多く体重をかけています。これはスタイルの選択であり、コーチの出発点であって、これが正しい構えだと主張するものではありません。
2. シミュレーションのファイター
すべての実験はMuJoCo 3.16を使い、1つの質量モデルを共有する2つの体で行いました。
- 筋肉の体。 平均的な成人男性で、1.75 m、77 kg(ウェルター級)です。各部位の質量はde Leva (1996)から、手足の周径はANSUR II調査の平均値から取っています。アクチュエータで駆動される関節が83あり、その可動域はAAOSの可動域表から取りました。タッチセンサーは14個です。接触には3種類の素材を使っています。柔らかい筋肉(手のひら大のプローブで50 Nのとき約8 mm、400 Nのとき14 mm沈む)、硬い骨(1 mm未満)、そしてグリップの効く手です。構え、リズム、スクリプトによる立て直し、最初のサバイバル実験はこの体で行いました。
- シンプルな体(v2)。 モーター37個と衝突形状23個です。各部位にカプセル1つ、拳は箱、足は箱にかかとの球とつま先のカプセルをつけたものです。立つことと打つことに重要な関節、つまり腰(胴)、首、鎖骨、肩、肘、手首、股関節、膝、足首、つま先は残しています。各部位の質量、重心、慣性は筋肉の体からコピーしているので、2つの体の全体的な質量分布は同じです。物理演算の1ステップにかかる時間は161 µsで、筋肉の体の423 µsより短くなっています。
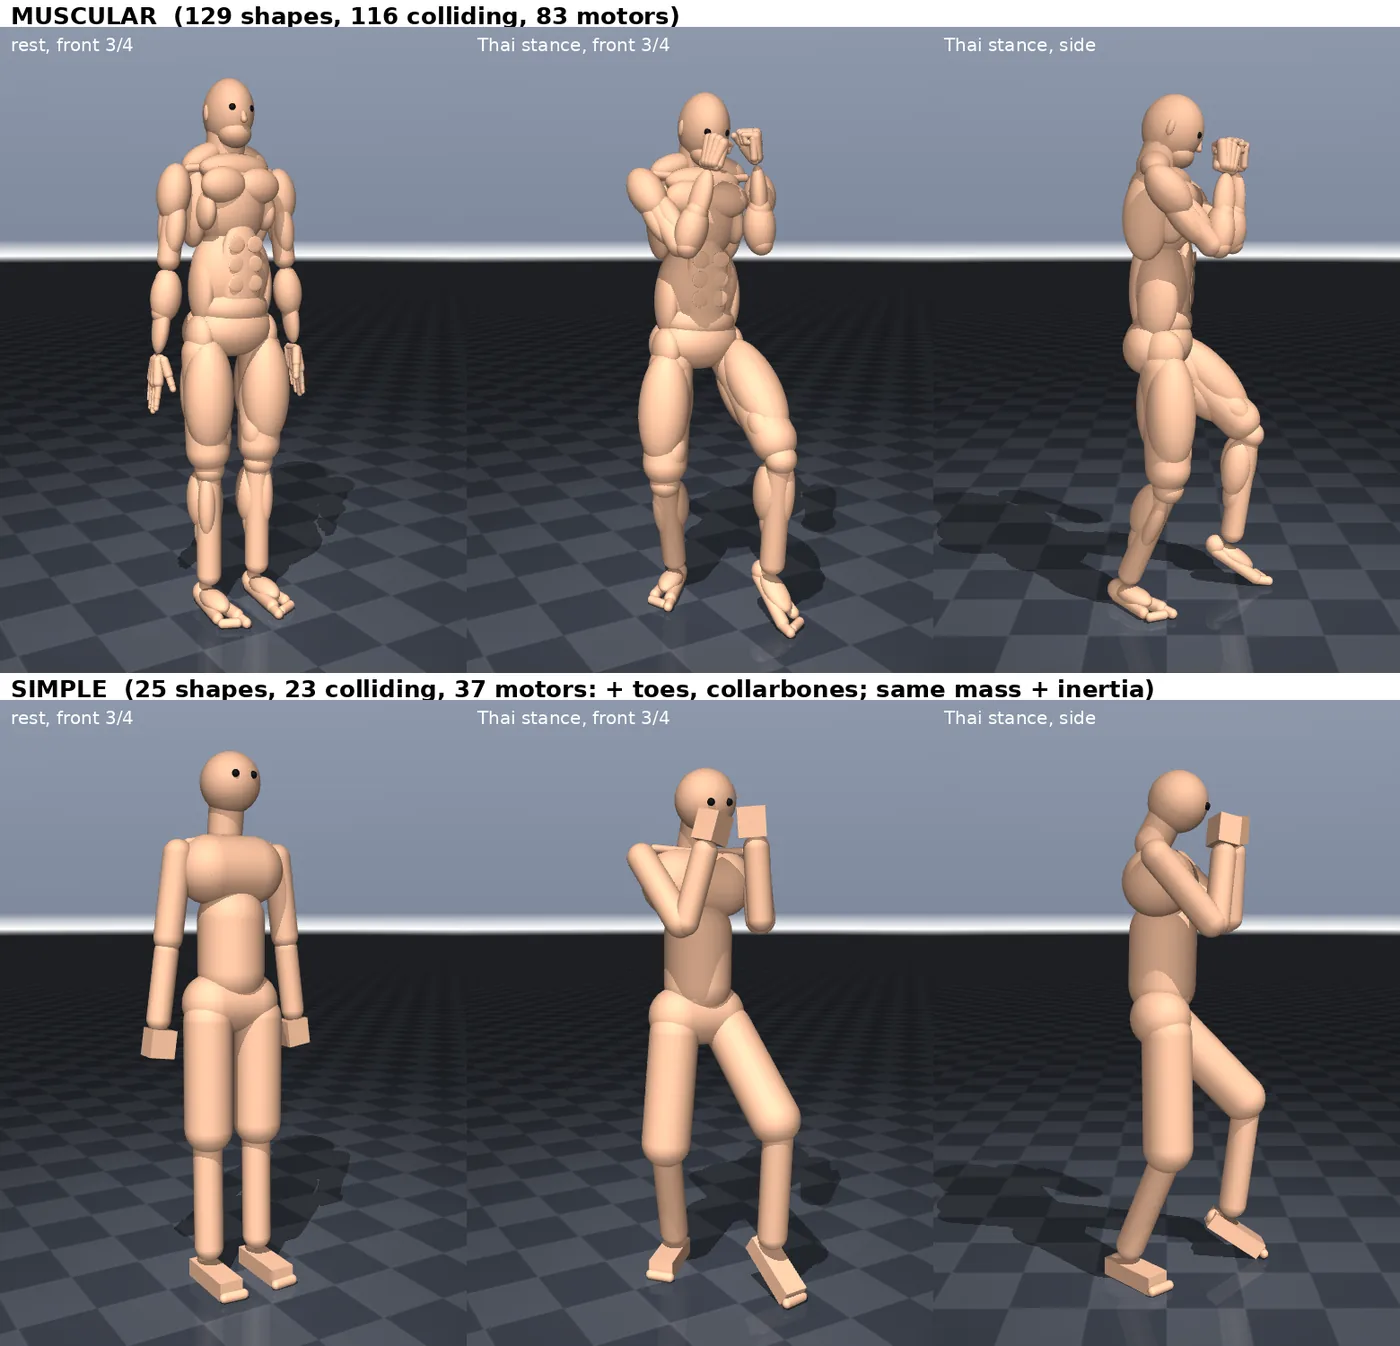
どちらの体にも収縮する筋肉はありません。すべてのモーターはトルクに上限のある位置サーボとして駆動されるので、力んでも体が硬くなることはありません。
3. 構えを指定する
コーチが構えを言葉で説明し、それを数値にしました。
| 項目 | 値 |
|---|---|
| 体重の配分 | 後ろ足70 %、前足30 %(オーソドックス:左足が前) |
| 後ろ足 | 45°外向き、ベタ足 |
| 前足 | 前向き、かかとを35°上げる |
| スタンスの大きさ | 前後0.51 m、左右0.16 m |
| 体幹 | まっすぐ立て、胸は正面 |
| ガード | 高く:肘は肋骨の横に下ろし、グローブは額の前 |
関節角度を手で書いたものは1つもありません。solve_stance.pyが脚、体幹、腕の関節を山登り法で調整し、体がこれらの目標を満たし、重心(COM)が体重配分に必要な位置に来るまで続けます。こうして解いた構えが参照モーションになり、それ以降のすべての方策は、バランスが取れている間これを追従します。
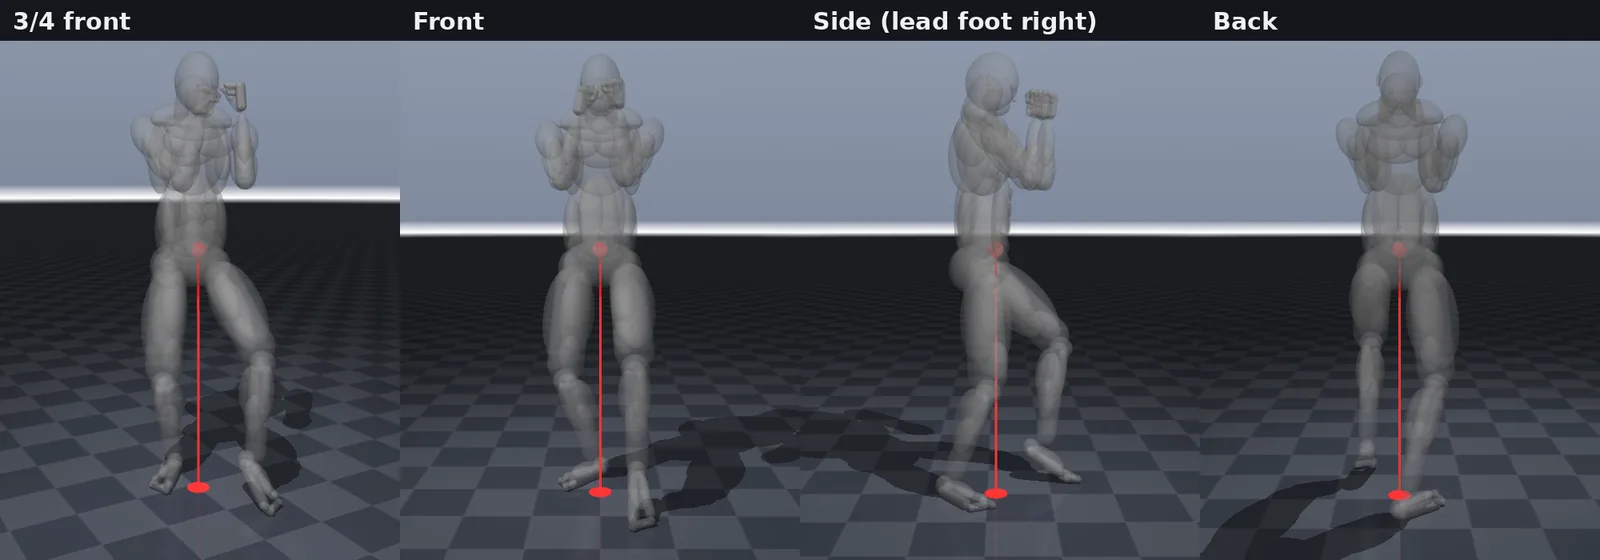
リズム
ムエタイのファイターはめったに静止していないので、参照モーションも動きます。1秒に1拍のペースで、腰は両足を結ぶ線に沿って約10 cm前に揺れ、構え(後ろ70 %)から50/50まで行って戻り、戻るときに2 cm沈みます。足は体重に合わせて母指球の上で転がります。体重が前にあるときは前足がベタ足になり、後ろのかかとが25°上がります。体重が後ろにあるときは後ろ足がベタ足になり、前のかかとが35°上がります。前足は2 cmタップし、胸は±2.5°回りますが頭は前を向いたままで、前の手は探るように動きます。振幅のダイヤルで、これらすべてを0(静止した構え)から1(リズム全開)まで調整できます。
リズムはコーチの要望で3回変更しました。最初は構えの周りで揺れていました(後ろ足に60–77 %)。次に、構えから前へ50/50まで揺れるようにしました。最後にかかとの転がりを加えました。コーチが、前足がいつもつま先立ちのままだと気づいたからです。
4. 構えを追従することを学ぶ
方策と行動
方策は2 × 256のMLPによるPPO(Schulman et al. 2017)のアクター・クリティックです。関節の目標値を直接出力するわけではありません。各出力は最大±0.4 radの残差で、環境がそれを現在のリズムの位相における参照ポーズに足します。その結果が50 Hzで位置サーボを駆動します。エピソードの長さは10秒です。各エピソードで、開始位相、毎秒0.8–1.3拍のテンポ、振幅がそれぞれ抽選されます。193個の観測は次のとおりです。参照に対する関節の誤差と関節速度。骨盤の向き、速度、参照からのずれ。足に対する重心の位置と足にかかる力。位相、テンポ、振幅。前回の行動とフィルタ後の行動。そして後述するバランスゲートです。
報酬の大部分(85 %)は追従に関するものです。関節角度、骨盤に対する頭・手・足の位置、後ろ足の上にある骨盤の位置、まっすぐ立った胸、後ろ足が受け持つ体重の割合、前足のタップ、地面についた後ろ足の母指球、そして両かかとの高さが含まれます。残りの15 %は滑らかさに報酬を与えます。転倒すると−1でエピソードが終わります。転倒とは、骨盤が0.3 m下がる、頭が1.1 mより下になる、または足以外の体の部位が床に触れることです。
カリキュラムは、エピソードが長く続き、めったに倒れなくなったら、リズムの振幅を0.1ずつ上げていきます。上げるたびに、エピソード2回分の長さを待ってから再び判断します。この待ち時間がなかった最初のランでは、古いレベルで始まったエピソードを根拠に、15イテレーションで0.2から振幅全開まで上がってしまいました。
ジッターと、その取り除き方
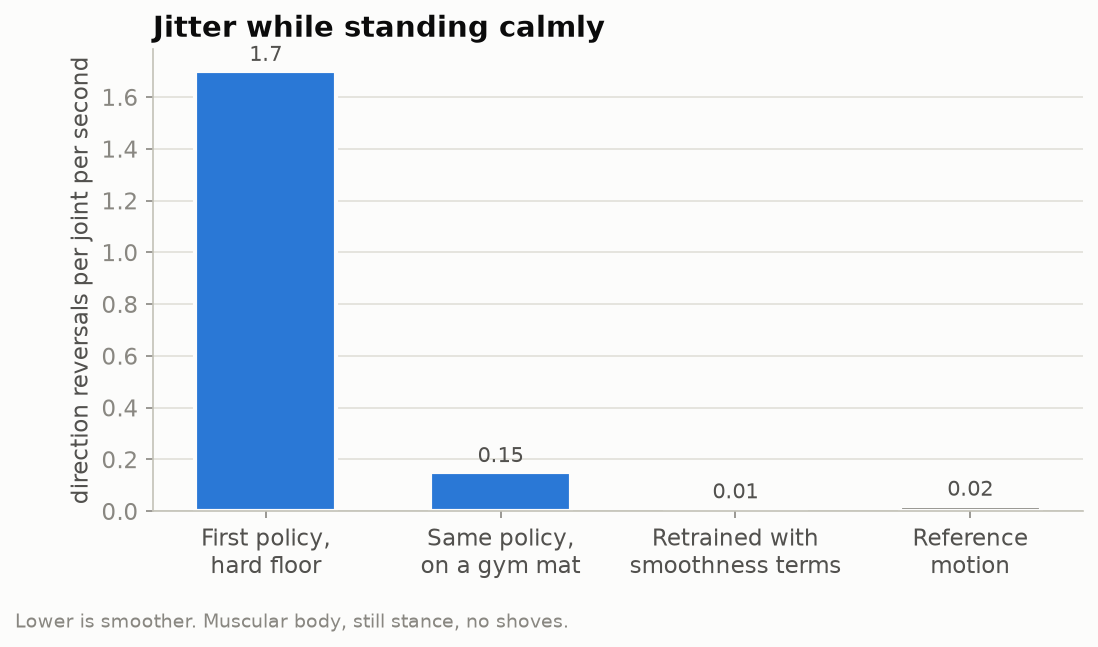
最初の方策(クラウドマシン1台で35分、7 Mステップ、$1未満)は、リズム全開を保てました。しかし見て分かるほどピクピクしていました。ジッターは関節1つ・1秒あたりの方向反転回数で測りました。落ち着いて立っているときは1.7、軽く押されたときは4.4でした。参照モーションは0.02です。震える構えをコーチが認めるはずはないので、次のランは滑らかさを中心に作り直しました。
- バランスゲート b ∈ [0, 1]。*キャプチャポイント*が参照のそれからどれだけ離れているか(6~15 cm)と、胸の傾き(10°~25°)を組み合わせたものです。キャプチャポイントとは、重心に、その速度をω = √(g / z)で割ったものを足した点で、体が止まるために踏み出さなければならない位置です(Pratt et al. 2006)。ゲートはすぐに上がり、0.5秒かけてゆっくり戻ります。
- 適応型の行動フィルタ f ← α·f + (1 − α)·a。バランスが取れているときはα = 0.8(約1.8 Hz)、崩れているときは0.2です。落ち着いているときは体が滑らかに動き、よろめいたときは素早く反応できます。
- 滑らかさの報酬は、ネットワークの出力だけでなく、実際の関節の動きにかけます。参照と一致する関節速度、反転がないこと、余計な加速がないこと、サーボの目標値が穏やかに変わること。バランスが崩れているときは、強さが20 %まで緩みます。
- PPOの損失関数に**CAPS正則化**(Mysore et al. 2021)を加えます。1つの項は連続する行動を近く保ち、もう1つの項は近い状態に対する行動を近く保ちます。
- ジムマットの床。 コーチのアイデアです。フォームの柔らかさ(足が約9 mm沈む)によって、何も変えていない古い方策のジッターが関節1つ・1秒あたり1.7回から0.15回に、11分の1に下がりました。硬い床の上で足が細かく跳ねなくなったからです。
再学習の後、落ち着いているときのジッターは関節1つ・1秒あたり0.01回になりました(図3)。かかとの転がりを入れた最終的な方策は、軽く押されたときで約0.1–0.2です。軽く押されても、体重の73 %を後ろ足に乗せたまま静止した構えを保ちます。この方策を固定し、以降すべての親としました。
5. 押しのテスト
生徒の構えが正しく見えたら、コーチは押して確かめます。簡単に押されてバランスを崩すなら、その構えはまだ機能していません。私たちも同じことをしました。
軽い押し(1.5~4秒ごとに胸へ20–60 N)は、最初から構えの学習に含めていました。この段階でもっと強い押し(40–160 N)を入れると70 %のエピソードで倒れたので、それは後回しにしました。その後、好奇心からさらに強く押し続けたところ、構えはついに崩れました。
ここから使う押しのモデルは次のとおりです。
- 2~4秒ごとに1回、0.10–0.20秒間の押し。方向はあらゆる向きで、主に胸、ときどき肩や腰
- 力は30 Nから、カリキュラムのレベルで決まる最大値まで:Fmax = 80 + 520 · level ニュートン。レベル1.0で600 N、レベル1.5で860 N
- そのレベルでの直近10–20イテレーションの平均で、転倒が20 %以下かつ平均エピソード長が10秒中8秒以上になったら、レベルを0.1上げます。1イテレーションだけで判断するルールでは、ノイズで上がってしまいました。
崩れ方から学べることがあります。前後からの150 Nの押しは吸収されました。構えがその方向に長いからです。横からの100–150 Nの押しは、構えでは止められないゆっくりとした流れ(約0.2 m/s)を生みました。キャプチャポイントが足の端までじわじわ進み、体は押しの後0.6–2.4秒で倒れました。押している最中に倒れることは一度もありませんでした。固定した構えの方策は、30–150 Nで胸を押すと30エピソード中15回倒れ、押しがなければ30回中0回でした。構えだけではこうした押しに耐えられません。足が動かなければならないのです。
6. アプローチA:スクリプトの動きによる立て直し
最初のアプローチでは、体にどう立て直すかを、コーチのスタイルで教えます。
手本となる立て直しの動き
キーフレームで立て直しの動きを設計しました。逆運動学で脚を解き、単調3次スプラインでキーフレームをつなぎます。それぞれの動きに0から1までの大きさのダイヤルがあります。
- 横へのホップ(
recover_side.py)。横から押されると体重が片足に集まり、その足はそのままでは踏み出せません。代わりに、軽いほうの脚をカウンターウェイトとして持ち上げて外へ伸ばし、体幹は体重のかかった足の上に傾けて、スケーターのようなT字になります。ふくらはぎが体重のかかった足を母指球まで押し上げ、足は横へホップします(最大で外へ35 cm、上へ5 cm)。母指球から着地し、ホップを吸収しながらかかとを下ろします。浮いていた足は広く(最大45 cm)着地し、バランスが戻ったら足をすり足で構えに戻します。その間ずっと、ガードは胸の前にあります。左への押しでは前足でホップします。右への押しはその鏡像で、後ろ足でホップします。 - 前後へのステップ(
recover_sagittal.py):前へのランジステップ、または母指球で後ろへ下がるステップです。コーチがステップしている写真をもとにしています。
各動きは5つの大きさで、0.02秒ごとのフレームとして表にしてあります。初期のバージョンには脚が交差してしまう逆運動学のバグがありました。今はプレビューで手足の間の隙間とIKの誤差を確認しています。
いつ立て直すか、そして方策がどう関わるか
立て直しはキャプチャポイントによって発動します。キャプチャポイントがマットに触れている足の輪郭から出たとき、または80 msの間その端から2 cm以内にあって0.08 m/s以上で外へ動いているか、0.15 m/s以上で流れているときです。出た方向で動きが決まり、距離で大きさが決まります。そのうえで、立て直しは重みwでサーボの目標値を構えから動きへとブレンドします。方策には2つの出力が追加されます。動きの時計の速さ(0.5–2倍)と、最初の0.15秒間の±0.3の大きさの補正です。
報酬もブレンドします:r = (1 − w)·rstance + w·rrecovery。立て直しの報酬は、キャプチャポイントが支持領域の内側にあること、重心が落ち着くこと、体幹がまっすぐなこと、ガード、手本の動きに対するスタイル、足とかかとの高さ、そして滑らないことに対して支払われます。バランスが崩れているときは残差の範囲が変わります。脚は±0.6 rad、体幹は±0.4 rad、腕はわずか±0.15 radで、グローブが顔の前に残るようにしています。
うまくいかなかったことと、その修正
| ラン | 問題 | 修正 |
|---|---|---|
| balance | 最初のレベル(最大150 N)で停滞し、11 Mステップ後も転倒が約49 %。立て直しの開始が遅すぎ(横からの100 Nの押しで1.1秒後に発動)、動きが小さすぎた | すべての動きを最低でも半分の大きさにし、支持領域の15 cm外で最大の大きさに。上で述べた早めの流れトリガー(今は100 Nの押しから160–200 msで発動)。最初のレベルを80 Nに緩和 |
| balance2 | たまたま良かった単一のイテレーションでレベルが上がった | 10–20イテレーションの平均でのみ上げる |
| balance3 | 報酬ハッキング:押しがまったくなくても、方策は95 %の時間を立て直しモードで過ごした。キャプチャポイントを端の近くに保って立て直しを繰り返し発動させていた。広くまっすぐな立て直しのポーズ(1ステップあたり約0.7)が、実際に保てる構え(約0.75)とほぼ同じだけ報酬をもらえたからだ。その後、学習はNaNに発散した | 立て直しの報酬の上限を約0.6にし、良い構えの1ステップより低くした。体が落ち着いたら立て直しを終える。立て直しの最中は、本当に支持領域から外れたときだけ新しい立て直しを始める。有限でない数値を含む更新は、トレーナーが巻き戻す |
これらの修正により、balance4は約68 Mステップでレベル1.0(600 N)に達し、115 Mまで安定していました。学習中の転倒は21–48 %で、押しのない時間に立て直しモードにいた割合は0 %だったので、ハッキングはなくなりました。同じ押しの系列を使う決定論的な12エピソードの固定テストでは、レベル1.0で12回中3回倒れました。統制された押しのグリッド(8方向 × 2種類の力)では16回中9回耐えました。後ろと左後ろからの押しには両方の力で、右からの押しには600 Nで失敗しました。右への押しでは体重のかかった後ろ足を35 cm動かさなければならず、1回の押しの後に2~4種類の動きをつなげてしまうことがよくありました。
スクリプトの動きによって、立て直しには見て分かるスタイルが生まれました。しかし同時に、体はそれらの動きに限られてしまい、最も強い押しにはその中にない何かが必要でした。
7. アプローチB:ガードを上げたまま生き残る
2つ目のアプローチは1つ目と並行して進め、スクリプトの動きを取り除きます。バランスを崩したら、体は倒れずにいられることなら何をしてもかまいません。ただしコーチから2つのルールがあります。手は上げたまま、そして立て直したら構えに戻ることです。
サバイバルモード
キャプチャポイントによる発動、押し、カリキュラムはアプローチAと同じです。変わるのはバランスを崩したときに起きることだけです。
- 手本の動きはありません。 サーボの目標値は、静止した構えに残差を足したものです。wが上がるにつれて残差の範囲は脚で±1.5 rad、体幹で±0.8 radまで広がり、関節の可動域で制限されるので、腰と脚は自由に動けます。
- ガードは二重に強制されます。 腕の残差は±0.15 radのままなので、グローブは物理的に顔から離れられません。さらに報酬には、グローブの位置に対するガードの項exp(−50 · ‖g − g0‖²)も含まれます。
- 報酬は生き残ることだけです。 立っていれば1ステップあたり0.4、ガードに最大0.1、転倒で−1です。ポーズ、スタイル、足、滑らかさの項はなく、行動フィルタも開きます。1ステップあたり最大0.5なので、バランスを崩した状態が良い構えの1ステップ(約0.7–0.8)より多くもらえることは決してありません。
- 構えに戻る。 バランスが取れると、構えの報酬がすべて再び適用されます(構え90 %、ガード10 %)。ですから方策は構えに戻ることで得をします。
どちらのアプローチも同じ方策、つまり第4節で固定した構えとリズムの方策から始めました。ですからサバイバルモードの立て直しは、スクリプトのホップを一度も見せられていません。そこにどんなスタイルがあるとしても、それは出発点(戻らなければならないコーチの構え、ガード、フットワーク)と物理から来ています。
学習させるまで
| ラン | 問題 | 修正 |
|---|---|---|
| survive | モードは体が再び構えと一致したときにしか終わらず、自由なステップでそうなることはめったにない。そのため体が落ち着いていてもモードがオンのままで、姿勢を導くものが何もなく、足が0.9 mまで開いていって倒れた。最初のレベルで約24 Mステップ | 落ち着いたら終了:キャプチャポイントが足の内側2 cmに入り、重心が0.1 m/sより遅く、胸の傾きが10°以内という状態が0.2秒続いたら、少なくとも0.3秒経った後にモードを終える |
| survive2 | 転倒の−1は、その原因となったミスの1~2秒後に届いた | ポテンシャルに基づくシェーピング(Ng et al. 1999):F = 0.99·φ(s′) − φ(s)。φはキャプチャポイントが足の外にあること、10°を超える傾き、骨盤が3 cmを超えて下がることにペナルティを与える。どの方策が最適かは変わらず、落ち着いた構えではほぼ0。7.4 Mステップでレベル0.2 → 0.7 |
| survive2 | 崩壊:行動の平均が±1の外へずれていった(平均|μ| 17)。行動はクリップされるので、引き戻すものが何もなく、すべての関節が可動域の限界に張りついた | |μ| > 1に対する損失 |
| survive3–6 | 成熟した方策から再開したりウォームスタートしたりすると、約20回の更新で壊れた(転倒100 %) | 学習率を下げる:成熟した方策では3 × 10⁻⁴の代わりに5 × 10⁻⁵ |
これらの修正を入れたラン(survive7)では、コーチの要望でカリキュラムを1.0の先まで進め、レベル1.5、最大860 Nに到達しました。そのレベルでの学習中の転倒は、探索ノイズとランダムな押しのもとで約10–11 %に落ち着きました。決定論的な方策の結果は次のとおりです。
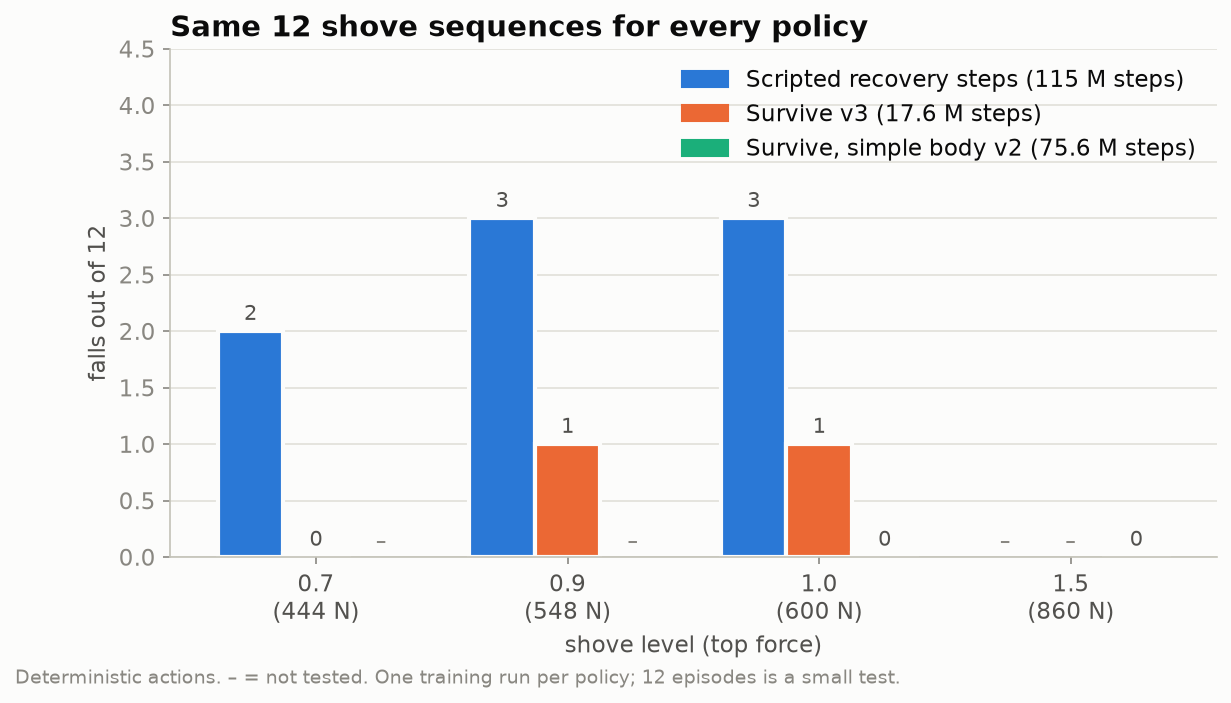
| 固定テスト、12回中の転倒 | 押しなし | 0.7 (444 N) | 0.9 (548 N) | 1.0 (600 N) | 1.5 (860 N) |
|---|---|---|---|---|---|
| A:スクリプトによる立て直し(balance4、115 Mステップ) | 0 | 2 | 3 | 3 | – |
| B:サバイバル(survive3、17.6 Mステップ) | 0 | 0 | 1 | 1 | – |
| B:サバイバル、低い学習率(survive7、55 Mステップ) | 0 | – | – | 0 | 0 |
75 Mステップの時点で、survive7はレベル1.5の押しのグリッドで16回中16回耐えました。2つのアプローチは報酬の細部や学習の長さも異なるので、これは1つの要因を切り分けた比較ではなく、2つの完成したレシピの比較です。
8. シンプルな体でゼロから
筋肉の体は、後の組み技のために作ったものです。バランスと打撃のためにシンプルな体に移り、サバイバルタスクをゼロから学習させました。構えやリズムの親はなく、カリキュラムは同じくレベル0からです。最初のシンプルな体にはつま先の関節も鎖骨もありませんでした。タスクは学習できましたが、コーチは却下しました。かかとを上げた構えでは、硬い足が板のように前の縁でバランスを取ってしまい、鎖骨がないので肩でガードの形を作れなかったのです。つま先と鎖骨を戻しました(v2、モーター37個)。コーチは速さよりもリアルさを選びました。
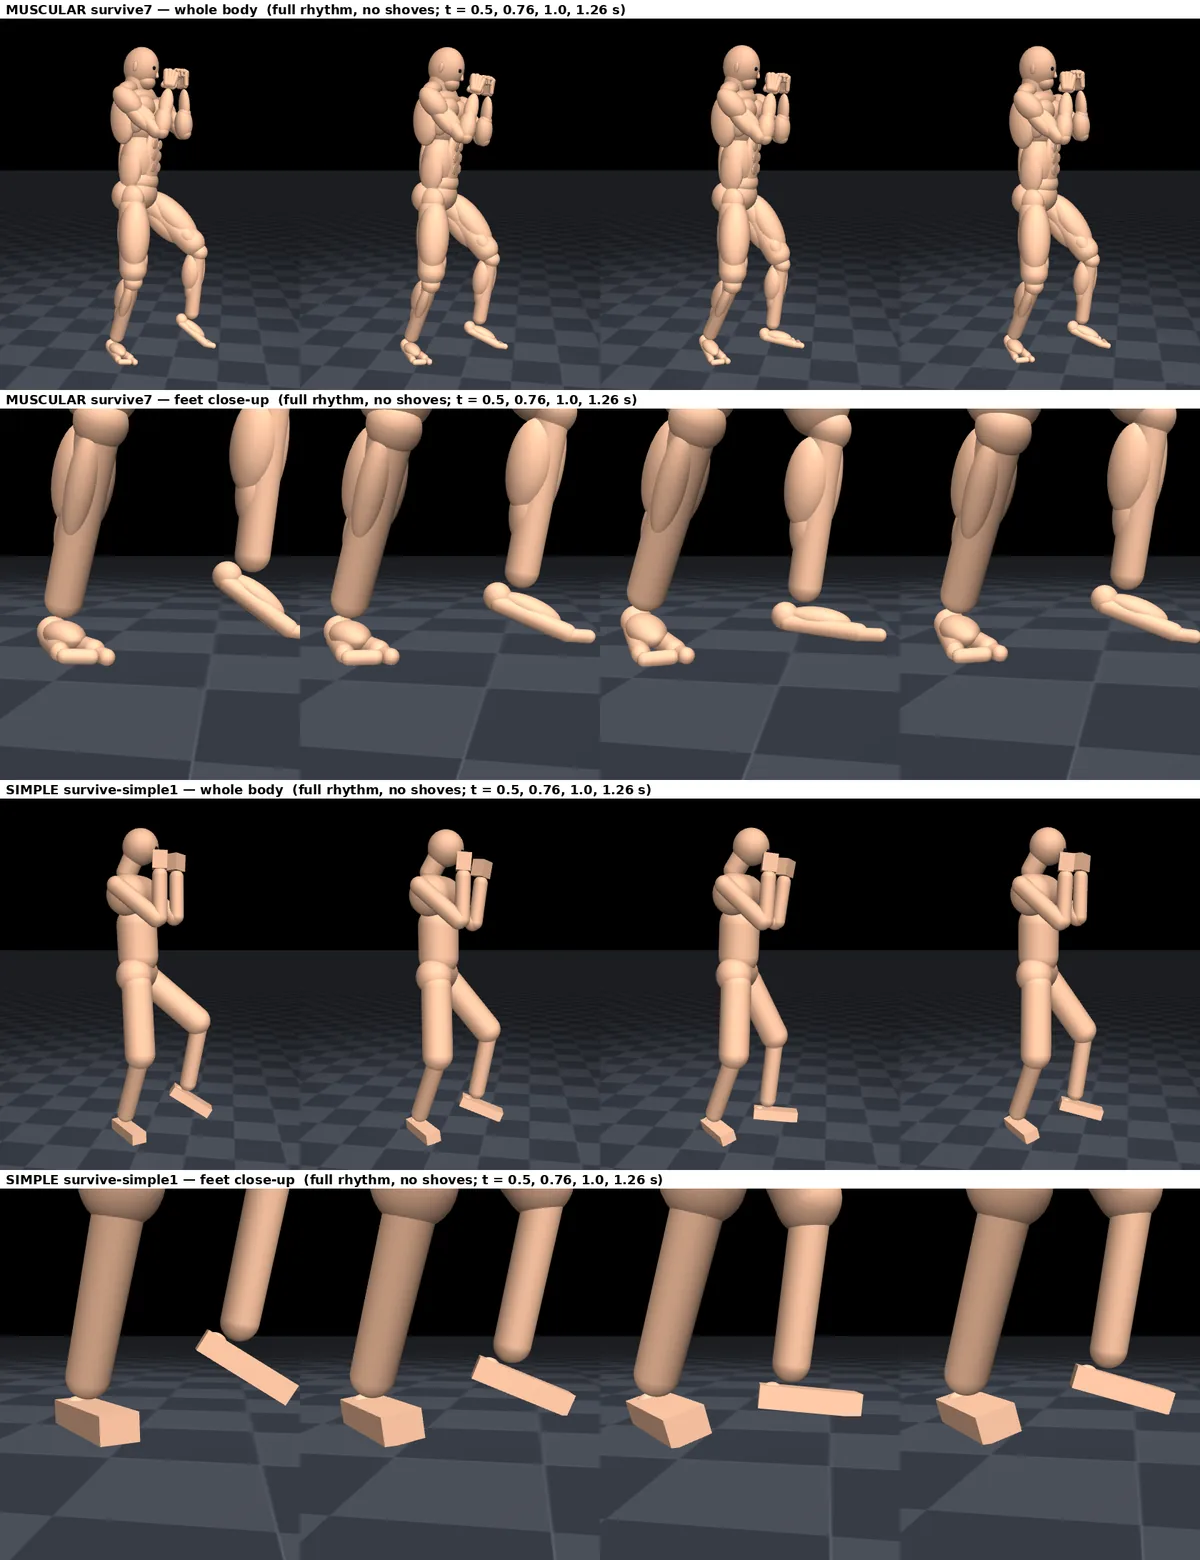
| シンプルv1(つま先・鎖骨なし) | シンプルv2 | |
|---|---|---|
| モーター | 31 | 37 |
| レベル1.5(860 N)到達 | 37.3 Mステップ、41分 | 33.6 Mステップ、39分 |
| 1.5での固定テスト、12回中の転倒 | 1 | 0(1.0でも0) |
| 1.5での押しのグリッド | 16回中14–15回 | 16回中15–16回、最終グリッドは16回中16回 |
| 合計 | 81 Mステップ、約1.5時間、約$1.50 | 75.6 Mステップ、約1.5時間、約$1.50 |
図6は、この固定テストを第6節と第7節の2つのアプローチと並べたものです。
比較のために言うと、筋肉の体はレベル1.0に到達するのに5回のランで約89 Mステップを要しました。その間、環境はまだ修正中でした。私たちは頭打ちになったらランを止めます。最高レベルでの学習中の転倒を10 Mステップの区間ごとに平均し、最新の区間が2つ前の区間より少なくとも1.5ポイント良くなっていなければ止めます。
9. コーチが決めたこと
点数が高いのに、格闘家の目にはおかしく見える結果がいくつもありました。次の決定は、指標ではなく、コーチが動画を見て下したものです。
- 構えそのものと、後ろ足に体重をかけるそのスタイル。
- 3回変更したリズム。報酬が求めていなかったかかとの転がりも含みます。
- 再学習の前にジッターを11分の1にしたジムマット。
- 実際のクラスと同じように押してテストし、さらに限界を超えて押して何が壊れるかを見ること。
- より大きな立て直しのステップ(「大きなステップなら遅れた反応も取り戻せる」)と、コーチがステップする写真から作ったステップの手本。
- サバイバルの実験:体に自分なりの立て直し方を見つけさせるが、手は上げたまま、構えに戻ること。
- 600 Nを超えて860 Nまで進めること。
- つま先のないシンプルな体を、学習はうまくいったのに、足が板のように見えるという理由で却下したこと。
10. 学習の環境と費用
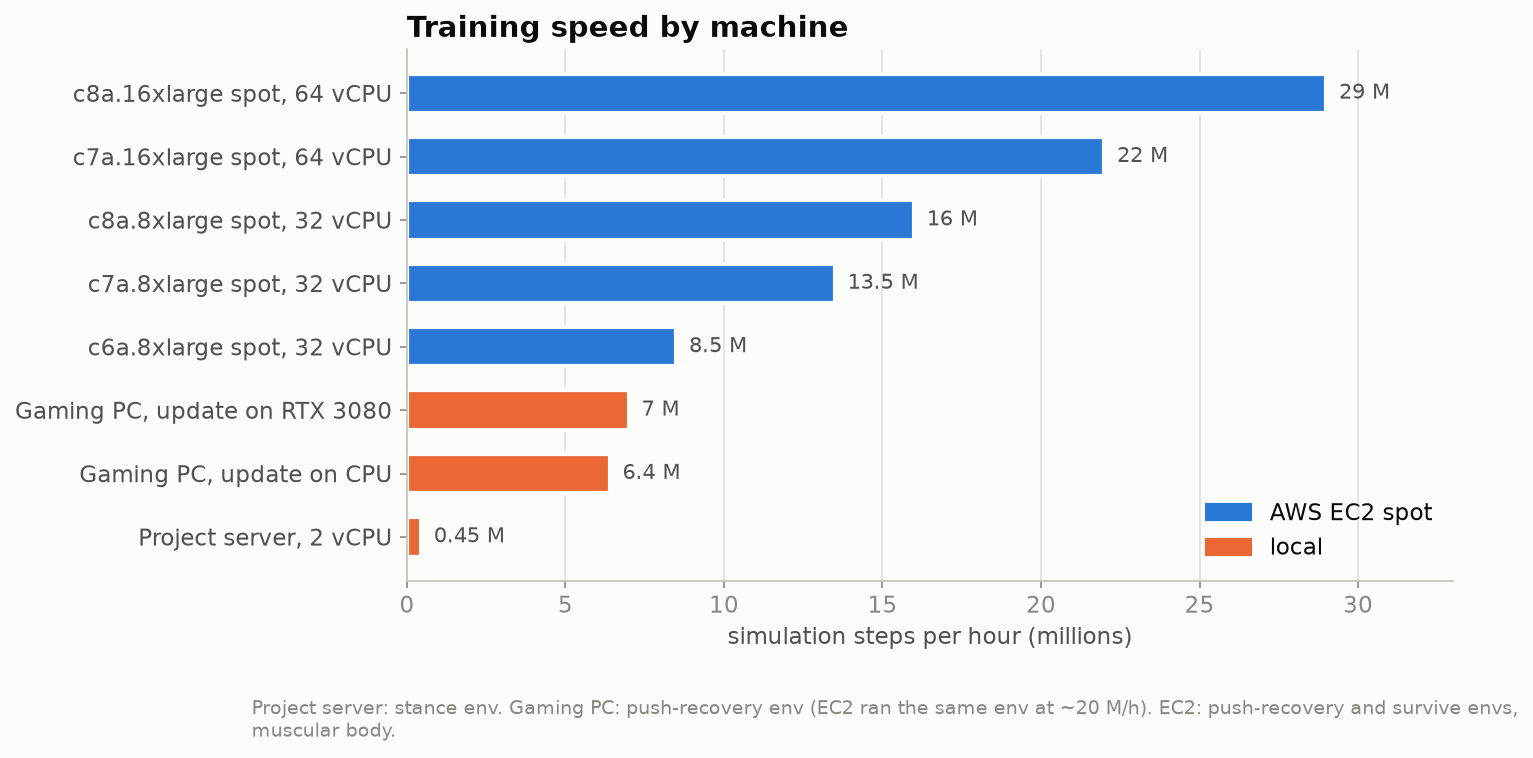
学習を開発用マシンで行ったことは一度もありません。すべてのランはus-east-1のEC2のスポットインスタンス1台を使いました。標準は64vCPUのc8a.16xlargeで、1時間約$0.93–1.23です(オンデマンドでは$3.28)。1時間に約29 Mの環境ステップを実行できるので、0.5–1.5時間の典型的なランの費用は$1–2です。シミュレーションは52個のワーカープロセスに分散し、それぞれが8つの環境を動かします。各ワーカーはロールアウトの間ずっと方策の自分用のコピーを動かすので、データ収集と更新が重なります(分離型PPO)。これにより、同じマシンでのスループットが1時間約14 Mステップから24 Mステップに上がりました(CPU使用率は28 %から65 %)。チェックポイントは60秒ごとにS3へ保存され、スポットが回収されたらウォッチャーがランを再起動し、インスタンスは期限が来たら自分で終了します。押しのレベルが上がるたびに、インスタンスは統制された押しのグリッド動画をレンダリングし、コーチが確認できるようにします。
バランスの作業にかかった費用
10月15日と16日の構え、リズム、押しのランでは、14回のEC2ランを使いました。それぞれの開始時刻と停止時刻を足し合わせると、64 vCPUのマシンで約15時間、32 vCPUのマシンで13時間になります。当日のus-east-1のスポット価格(c7a.16xlargeまたはc8a.16xlargeで1時間約$1.05、32 vCPUのc7a.8xlarge、c8a.8xlarge、m7a.8xlargeで$0.55–0.72)で計算すると、およそ**$24**になります。大きなマシンで約$16、小さなマシンで$8です。これとは別に1回のセッションを、オーナーのゲーミングPCで無料で動かしました。これらはランのログとAWSのスポット価格履歴からの見積もりで、請求書から出したものではありません。
マシンの選択は、いくつかの判断に集約されます。
- c7aで始め、c8aに移る。 最初のランはc7a.16xlargeを使いました。10月15日、オーナーが新しいc8a.16xlargeを求めました。c7aの22 Mに対して1時間約29 Mステップを実行でき(図7)、スポット価格も同程度だったので、これが標準になりました。
- 2つの実験に半分サイズのマシンを2台。 アカウントでは同時に64個のスポットvCPUまで使えました。スクリプトによる立て直しとサバイバルの2つのアプローチ(第6節と第7節)は、それぞれ32 vCPUのマシンで並行して学習させました。c8aもc7aも空いていないときは、m7a.8xlargeで代用しました。
- オンデマンドよりスポット。 スポットはオンデマンド価格の約3分の1でした。2日間でAmazonはマシンを8回回収しました。チェックポイントとウォッチャーのおかげで、回収のたびに失ったのはランそのものではなく数分で済みました。
- 長いランは、得たものより費用のほうが大きかった。 最も長い2つのラン、recover v3とsurvive3は、それぞれ32 vCPUのマシンで5~6時間動き、請求額の約4分の1を占めました。夜遅くにウォッチャーが使っていたログインの期限が切れ、どちらも見守られないまま期限まで動き続けました。survive3は回収の後、すでに崩壊していました。c8a.16xlargeでゼロから学習させたシンプルな体は、39分で最高の押しのレベルに到達し、ラン全体の費用は約$1.50でした。
運用上の教訓が2つあります。
- 進捗の動画は行動をサンプリングすること。 決定論的な方策は、学習中にまだ起きていた転倒を隠してしまいました。
- 成熟した方策は低い学習率で再開すること。 崩壊のうちいくつかは、タスクではなく、再起動後の最初の更新が原因でした。
11. 限界と次のステップ
- 体には筋肉の活性化がありません。力みによって硬さを変えることはできません。
- 「正しく見える」かどうかは、1人のコーチが1つのスタイルで判断しています。ほかの構え(ロングガード、異なる体重配分)には、それぞれの手本が必要になります。
- 学習ではバランスを転倒の回数で測っています。サバイバルの立て直しのスタイルは、動画を見て目で判断しているだけです。
- 本物のファイターは安全に倒れること(受け身)もします。それはもっと後の段階です。
次は、この安定した土台の上に積み上げます。構えからの打撃、まずは狙ったジャブからです。
参考文献
- Schulman, J., Wolski, F., Dhariwal, P., Radford, A. and Klimov, O. (2017). Proximal Policy Optimization Algorithms. arXiv:1707.06347.
- Ng, A. Y., Harada, D. and Russell, S. (1999). Policy invariance under reward transformations: theory and application to reward shaping. ICML.
- Pratt, J., Carff, J., Drakunov, S. and Goswami, A. (2006). Capture point: a step toward humanoid push recovery. IEEE-RAS Humanoids.
- Mysore, S., Mabsout, B., Mancuso, R. and Saenko, K. (2021). Regularizing action policies for smooth control with reinforcement learning. ICRA.
- Hilton, J., Cobbe, K. and Schulman, J. (2022). Batch size-invariance for policy optimization. NeurIPS.
- Todorov, E., Erez, T. and Tassa, Y. (2012). MuJoCo: a physics engine for model-based control. IROS.
- de Leva, P. (1996). Adjustments to Zatsiorsky–Seluyanov’s segment inertia parameters. Journal of Biomechanics 29(9).
- Gordon, C. C. et al. (2014). 2012 Anthropometric Survey of U.S. Army Personnel (ANSUR II). U.S. Army Natick.
- American Academy of Orthopaedic Surgeons (1965). Joint Motion: Method of Measuring and Recording.