
コスト · GPU · 学習速度
2人のファイターと視覚:最適化したGPUとCPUの比較
学習コスト 約$6マシン19台(ベンチマークとテスト)、約5.5マシン時間 · 内訳
レンタルGPUで学習するの記事では、ファイターが最初に覚えた技、つまり押されながら構えて立つことを題材に、9種類のGPUとEC2のスポットマシンを比べました。レンタルのカードのほうが約4.5倍安いという結果でした。それ以来、学習は対戦相手のブロックへと進み、はるかに重い仕事になっています。コーチのヤム トニーはこう言います。
構えとバランスについては、いろいろなGPUでもう分析しました。でも今は2人のファイターと視覚がある、もっと複雑なモデルになったので、分析をやり直したいんです。ただ、GPUの選択肢を絞るために、前回の学習で一番効果的だと証明されたRTX 5090だけを選びました。そのうえで、EC2スポットでのCPUの使い方とRTX GPUの両方を最適化し続けて、どこまで行けるかを見て、もう一度CPUとGPUの価格と速さを比べます。
そこでこの記事では、1つのGPU(vast.aiで借りたRTX 5090)と1つのCPUマシン(96 vCPUのEC2スポットマシン)を比べます。まずそのままの状態で両方を測り、それぞれをほとんど伸びしろがなくなるまで最適化して、もう一度比べます。前回と同じく、ここで学習したモデルは捨てています。
この学習が重い理由
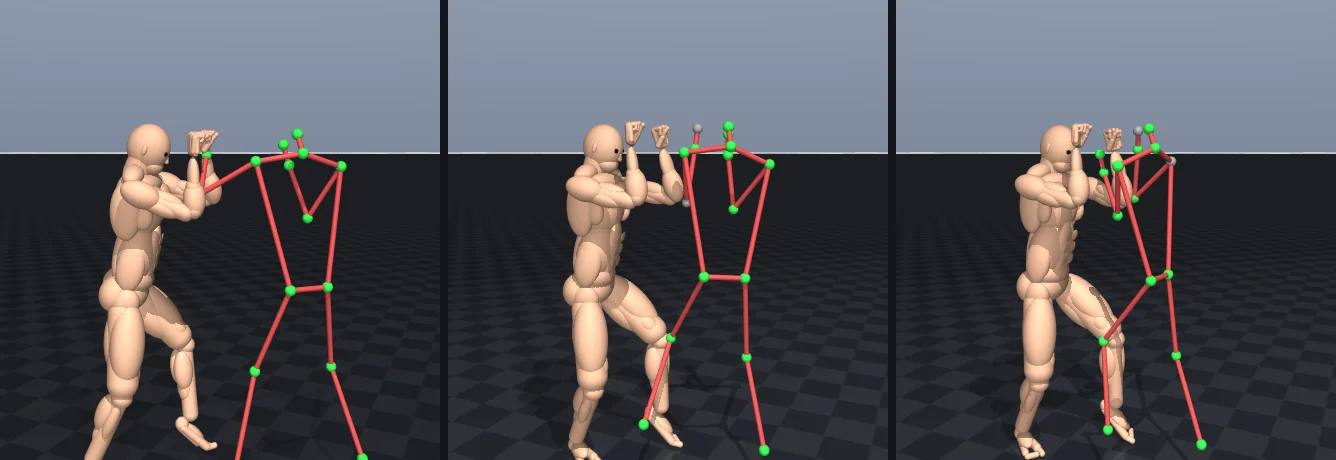
構えのテストでは、体1つとネットワーク1つを学習していました。ブロックの学習(ブロックの記事の環境に、今はすべての技を混ぜたもの)では、1ステップごとにはるかに多くのことが起きています。
- 2人のファイター。 私たちのファイター(筋肉の体)と、記録したパンチを打ってくる対戦相手です。
- 視覚。 ファイターは対戦相手の位置をただでもらえるわけではありません。自分の目から相手のキーポイントを見ます。相手の体の各点へ32本の光線を飛ばし、自分のグローブの陰にある点は隠れます(オクルージョン)。しかも0.1秒の遅延付きです。
- パンチの採点。 パンチが届くと、グローブから頭への19本の軌道で、そのうちどれだけがガードを抜けたかを判定します。
- すべてを混ぜる。 一部のエピソードは対戦相手と向き合い、残りは合図でのブロック、指定の場所への歩き、サンドバッグへのパンチ、押されたところからの立て直しです。ブロックを押すたびに、逆運動学で腕をポーズに合わせます。
- 2つ目のネットワーク。 これまでの記事の歩きモデルが、教師として方策と並んで動き、脚を良い歩き方へ引き寄せます(方策蒸留)。
テストの方法
両方のマシンとも同じモデル(guard5、現時点で最も良いブロックのモデル)から、実際の学習と同じ設定で始め、15分間学習させます。
作業の単位はPPOの学習イテレーション1回です。多数の世界のコピー(並列環境)から一度に約30,000ステップを集め、それを使ってネットワークを更新します。2,048のミニバッチで4パスです。構えのテストで、ファイターの学習の速さを決めるのはステップ数ではなくイテレーション数だとわかりました。そこでここでは、速さをイテレーションあたりの秒数、コストを1,000イテレーションあたりのドルで表します。
- CPU: 96 vCPUのEC2スポットマシン。72のワーカープロセスが、それぞれ6つの世界のコピーを64ステップずつ進め(1イテレーション27,648ステップ)、12スレッドのラーナープロセス2つがネットワークを更新します。
- GPU: RTX 5090が2,048のコピーを一度に16ステップ進めます(32,768ステップ)。物理演算もネットワークも、すべてMuJoCo Warpでカードの上で実行します。
| EC2 96 vCPU スポット | RTX 5090、vast.ai | |
|---|---|---|
| 価格 | $1.48/h(c8a)、$2.58/h(m8a、空いていたもの) | $0.67/h |
| イテレーションあたりの秒数 | 1.90 | 2.00 |
| 1秒あたりのステップ数 | 14,600 | 16,300 |
| 1,000イテレーションあたりの$ | 0.78(c8a)、1.36(m8a) | 0.37 |
最適化前は、両者の所要時間は同じで、GPUのほうが2.1倍安くなりました。構えでは4.5倍でした。2人のファイターと視覚によって、差が縮まったのです。
CPUはどれだけ働いていたか
数字が出たとき、トニーが最初に聞いたのはこれでした。「CPUはどれくらい最適化されていますか?つまり、CPUの使用率はどれくらいですか?」
約4分の3です。学習器のプロファイルは、各イテレーションを2つに分けます。ラーナーが前のバッチで更新している間に、ワーカーは次のバッチを集めます(分離型PPO)。そのため1イテレーションにかかる時間は、2つのうち遅いほうで決まります。
- ラーナーの更新には1.90秒かかり、これがイテレーション全体でした。ボトルネックはラーナーでした。
- 72のワーカーは物理演算を1.34秒進めたあと、ラーナーを0.56秒待っていて、時間の30 %は遊んでいました。
つまり96 vCPUのうち24は常に稼働し、72は時間の70 %稼働していました。全体で約77 %です。
GPUの最適化
ステップの時間はどこへ行っていたか。 2,048のコピーでの1ステップをプロファイリングすると、GPUが実行する小さなプログラムであるカーネルが13,700個ありました。そのうち約1,800はMuJoCo Warpの物理演算、光線、腕の合わせ込みでした。残りの11,700は、PyTorchで1行ずつ書かれた報酬、観測、リセットから生まれた、ごく小さな算術カーネルでした。それぞれはほとんど仕事をしないのに、どれにも一定の起動コストがかかります。GPUはステップの多くの時間を、カーネルとカーネルの間で待つことに費やしていたのです。
カーネルを融合する。 torch.compileはそのPyTorchのコードを読み、小さな演算の連なりをいくつかの大きなカーネルにまとめます(カーネル融合)。物理演算の呼び出しはその対象から外し、これまでどおり実行します。2,048のコピーでの1ステップは79.5 msから60.2 msになりました(図2)。
途中で2つのことを直す必要がありました。最初、コンパイルされたコードはバラバラに分かれてしまいました。テーブルのオフセットの一部がnumpyの整数で、コンパイラがそれを定数ではなくデータとして扱っていたためです。次に、一部の出力が32ビットではなく64ビット(浮動小数点)で出てきました。プロジェクトの設定値は、4度の許容誤差np.radians(4.0)のようなnumpyの数値で、普通のPyTorchはそれをただの数として扱うのに、コンパイラは64ビットの配列に変えていたのです。今はステップの出力を32ビットに戻しています。同じ開始状態と同じ行動から、コンパイルしていないステップと比べると、最初の数ステップでは報酬が10万分の3の精度で一致し、その後は接触のある物理演算の32ビットのラン同士が必ずそうなるように少しずつずれていきましたが、平均は同じでした。
更新を1つの記録にする。 ネットワークの更新が、イテレーションの残りの0.53秒でした。書いたままの状態で実行すると、何百もの小さなカーネルがホストのCPUから1つずつ送られます。そしてレンタルの5090の多くは、遅いサーバー用プロセッサの後ろにあります。同じ更新が、速いデスクトップ用プロセッサのマシンでは0.13秒、よくあるEPYCサーバーでは約0.5秒かかりました。ミニバッチ1ステップを一度記録して再生する(CUDAグラフ)と、CPUが関わらなくなり、0.08秒になりました。
この記録の仕組みはすでにありましたが、オフにされていました。記録したあとの最初のロールアウトで、どのvast.aiのマシンでもGPUが不正なメモリアクセスでクラッシュしていたからです。同じ部品だけのテストではクラッシュせず、学習器の追加機能を1つずつ戻していってもクラッシュしませんでした。うまくいったのは、更新の記録を、環境自身の記録の後ではなく前に行うことでした。538イテレーションと792イテレーションの2回のランは問題なく走りました。根本的な原因はまだわかっていません。おそらく2つの記録のメモリの問題です。
結果:1イテレーション1.19秒、1秒あたり27,500ステップで、以前の2.00秒からの改善です。今は環境ステップがそのうち1.09秒、更新が0.08秒です。普通のEPYCをホストにした5090での20分のランは、ベースラインの学習の数値とイテレーションごとに一致しました。リターン、転倒、パンチ、目標、ブロック、対戦相手への合格がすべて同じで、変わったのは時間だけでした。
CPUの最適化
ラーナー。 12スレッドでは、1つのラーナーの更新は約1 TFLOPSで動きます。コアの理論上のピークの約半分で、これくらい小さなネットワークでは典型的な値です。96 vCPUをワーカーとラーナーに分ける方法を6通り試しました。24スレッドのラーナー1つ、8、12、16スレッドのラーナー2つ、8または12スレッドのラーナー3つです。ほとんどはイテレーションをほとんど変えませんでした。最も良かったのはワーカー60個(それぞれコピー7つ)と12スレッドのラーナー3つで、同じマシンで1イテレーション1.91秒から1.74秒へ、9 %速くなりました。
ラーナーをこれ以上増やすと損になります。ラーナープロセスを1つ増やすごとにall-reduceの負担が増えるからです。all-reduceは、ネットワークのどのコピーも同じであり続けるように、プロセス同士が勾配を足し合わせるステップで、ラーナー3つの時点ですでに1イテレーションあたり0.38秒かかっていました。
ビット数を減らす。 ネットワークのパスをbfloat16(AMDのプロセッサがより速く掛け算できる16ビットの数値)で実行すると、更新はほぼ半分になりました。12スレッドで0.88秒から0.48秒です。イテレーションは1.43秒になり、最初より25 %速くなりました。ただし数値がわずかに変わり、この方法で学習した方策が同じように学べるかどうかはまだ確認していないので、下の表では別に載せています。
ワーカー。 環境のコピー1つの1ステップには4.4 msかかり、そのうちMuJoCo自体は約1.6 msでした。残りは、その周りにあるプロジェクト独自のPythonとnumpyのコードでした。数値を1つずつクリップしたり、遅いヘルパーで配列を結合したり、テーブルを引いたりしていたのです。最も悪いところを書き直すと、環境1つが約20 %速くなり、6,000ステップにわたってすべての観測と報酬が最後のビットまで同一でした。72のプロセスがメモリを共有する96 vCPUのマシンでは、ワーカーの時間が7〜11 %短くなりました。しかしペースを決めているのは依然としてラーナーなので、これだけではイテレーションは短くなりませんでした。
マシン。 同じ作業をIntelのc8iマシンで行うと、1 vCPUにまるごと1コアを持つAMDのc8aやm8aに比べ、物理演算に1.45倍の時間がかかりました。使うべきなのはAMDのマシンです。
比較を公平に保つ
途中で、GPUの学習の数値が変わりました。1イテレーションあたりのブロックが1,150ではなく約200になり、パンチもずっと少なくなったのです。コンパイルしたコードが壊れているように見えました。しかしそうではありませんでした。コンパイルしない同じ学習器でも、同じように落ちていたのです。その朝、キックについての別の作業でファイターの足首の可動域が広げられ、すべての参照モーションが新しい体に合わせて作り直されていました。古い足首をマシンに送ると、ブロックは戻りました。
そのため最終的な数値は、両方のマシンで最初のテストと同じ体を使い、CPUの最適化前と後は1台のマシンで続けて走らせています。
最適化後の比較
| CPU、32ビット | CPU、bfloat16(注記付き) | RTX 5090 | |
|---|---|---|---|
| イテレーションあたりの秒数 | 1.91 → 1.74 | 1.43 | 2.00 → 1.19 |
| 1秒あたりのステップ数 | 14,500 → 15,300 | 17,800 | 16,300 → 27,500 |
| 1,000イテレーションあたりの$ | 0.78 → 0.71 | 0.59 | 0.37 → 0.22 |
| 100万ステップあたりの$ | 0.027 | 0.023 | 0.0068 |
| 学習前の有料の準備時間 | 約2分 | 約2分 | 約10分(約$0.11) |
CPUの価格は、最も安い96 vCPUのAMDマシンであるc8aのスポット価格($1.48/h)です。測定は同じプロセッサのm8aで行いました。GPUは$0.67/hです。
ここからわかること:
- RTX 5090は今や、EC2での最良の32ビット構成に比べてイテレーションあたり約3.2倍安く、しかも速い:1イテレーション1.19秒に対して1.74秒です。CPUでbfloat16のラーナーを使った場合と比べても2.7倍安くなります。ステップあたりでは約4倍です。
- 最適化でより多くを得たのはGPU:イテレーションが41 %短くなったのに対し、CPUは9 %(bfloat16で25 %)でした。GPUの無駄は仕事の起動(何千ものごく小さなカーネルと、それを1つずつ送るCPU)にあり、それは取り除けます。CPUのラーナーは、もともとまずまずの速さで計算していました。
- 最も安い5090でも、今はどれとも同じくらい良いはず。 更新を記録したことで、カードの横にあるCPUは記録を再生するだけになったので、$0.60〜0.67のサーバーマシンでも、速いデスクトップ用プロセッサを持つ$0.91のマシンと同じくらい速く走るはずです。最後のランは古いEPYCサーバーで1.19秒に達しました。
- GPUは起動に費用がかかる:これらのランでは、レンタルから最初のイテレーションまで約10分(起動、参照テーブルの再構築、物理演算と融合カーネルのコンパイル)、約11セントでした。1時間以上のランならほとんど問題になりません。
コーチ・トニーの考え
トニーはこれを新しい調査ではなく、前回の続きとして位置づけていました。GPUの選択はRTX 5090に絞る(「前回の学習で一番効果的だと証明された」)、そして「EC2スポットでのCPUの使い方とRTX GPUの両方を最適化し続けて、どこまで行けるかを見る」。最初の比較が出たとき、トニーが聞いたのはCPU側のこと、つまりマシンのどれだけが実際に使われているかでした。その後の指示は、両方を「かなり最適化できたと思うまで」最適化し続け、それからコストと速さを比べること、でした。
次は
- GPUのステップ。 1.09秒の約半分はMuJoCo Warp自体の物理演算で、残りは環境のカーネルと、毎ステップすべてのコピーで実行されるリセットです。コピーを増やしても時間はあまり増えない(4,096個で1ステップ99 ms、2,048個では60 ms)ので、4,096のコピーで8ステップずつにすれば、同じバッチを約0.8秒で作れるはずです。ただしそうすると、更新と更新の間の各コピーのランが短くなり、学習が変わるので、まず学習のテストが必要です。
- 起動。 コンパイル結果を毎回作り直すのではなく、マシン間で使い回せるかもしれません。
- CPUでのbfloat16は、使う前に学習のテストが必要です。ただ、GPUがここまで先行している今、CPUは予備の位置づけです。
かかった費用
費用の大半は、変更ごとに測定するための短いGPUとCPUのランと、GPUのクラッシュの原因探しに使われました。vast.aiの数値は各マシンの課金時間と時間単価から、EC2の数値は各ランの長さとそのゾーンのスポット価格からの見積もりです。
| 項目 | マシン | マシン時間 | 費用 |
|---|---|---|---|
| 最初の比較:それぞれ15分 | RTX 5090 1台、EC2 m8a.24xlarge 1台 | 約0.7 | 約$1.06 |
| GPUの最適化:ベンチマーク、クラッシュの原因探し、テストと最終ラン | RTX 5090 15台(2台は応答なし) | 約3.2 | 約$2.65 |
| CPUの最適化:ベンチマークと最終比較 | EC2スポット7台(c8i、c7a、c8a、m8a、96 vCPU) | 約1.4 | 約$3.00 |
| 合計 | 24 | 約5.3 | 約$6.70 |