
ムエタイ · ブロック · 知覚 · 報酬設計 · コーチング
ブロック:0.1秒遅れて見えるパンチを読む
学習コスト 約$33学習ラン20回、約16.7マシン時間 · 内訳
その他の動画

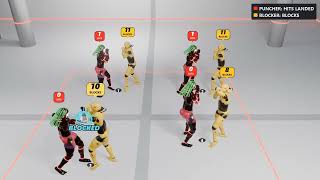
フットワークの記事を終えた時点で、ファイターは構えて立ち、5種類のパンチを打ち、指定の場所まで歩けるようになっていました。ただ、これまでの目標はすべて空中の一点かサンドバッグ(バッグ)でした。どれも打ち返してはきません。
今回の記事のテーマは防御です。コーチのヤム トニーは、なぜそれが難しいのかをこう説明します。
ブロックというのは複雑なものです。まず反応時間があります。目で見て処理しているものは、実際には現実より遅れているんです。それに、相手が本当は何を考えているのか、ジャブを打つのかフックを打つのかはわかりません。手がかりは見た目だけです。腰の回転、肩や肘の動き。それがフェイントになることもある。だから、とても面白いチェスのようなものなんです。
そして、この最初の一歩で省いているもの。
実際の試合では、距離のことを考えます。相手を打撃の届く距離に立たせたまま、ただ突っ立っているなんてことはしません。普通はポケット(打ち合いの距離)に出たり入ったりします。ジャブを避けるために頭を振るかもしれない。動く準備をしているかもしれないし、打ち合うかもしれない。「あの速いジャブは誘いだ」と考えて、実は外へ動いて大きなクロスを打とうとしているかもしれない。そういうことを全部考えています。でも、一歩ずつです。
そこで今回は、射程内に立つ対戦相手から一度に1発ずつパンチが来て、ファイターはブロックしかしてはいけない、という設定にしました。スリップも、後ろに下がるのも、カウンターもなしです。ファイターには対戦相手が0.1秒遅れて見え、相手の最初の動きからどのパンチが来るのかを見分けなければなりません。
この記事は、10月19日23:43 UTCから10月20日18:04 UTCまで、約18時間にわたる20回の学習ランをまとめたものです。採用されたモデルの学習が終わったのは10月20日17:43 UTCでした。
4つのブロック
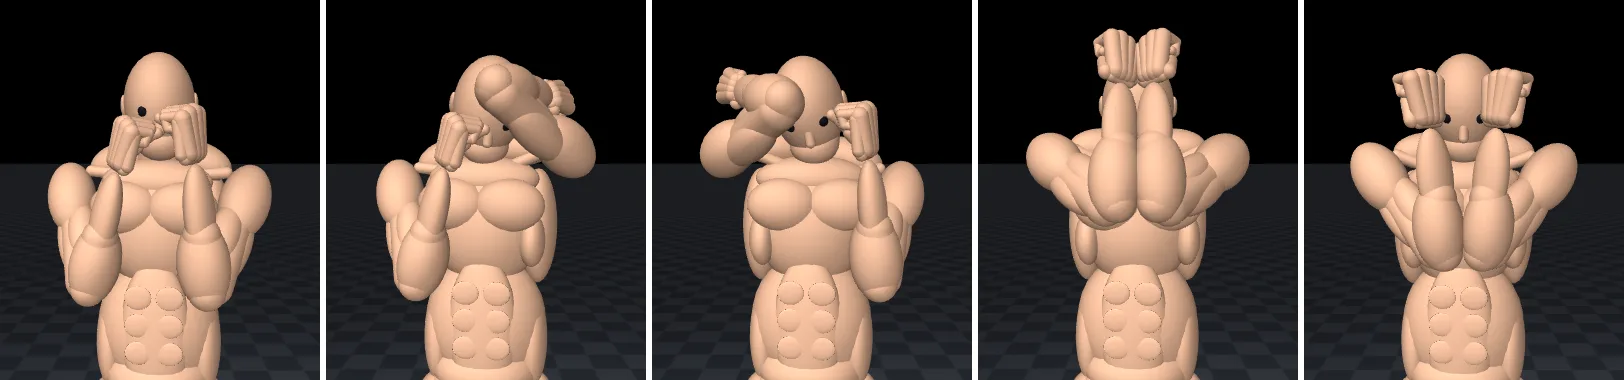
トニーが求めるブロックの写真を送り、そこから4つのポーズを作りました(図1)。
- 左ハイブロック:対戦相手の右フックに対して。左肘を顔の前、額の高さまで上げ、前腕をこめかみに沿わせて後ろへ。あごは引きます。
- 右ハイブロック:同じ形を右側で。左フックに対して使います。
- フロントブロック:ジャブとクロスに対して。両前腕を立てて、顔の前でくっつけます。
- ローフロントブロック:アッパーカットに対して。フロントブロックの肘を胸まで下げ、前腕であごの下の隙間を塞ぎます。
ファイターは素手で戦います。グローブも試しましたが、その日のうちにやめました。ガードの姿勢でグローブが目を覆ってしまうことと、ファイターは後々組み技もするためです。
ステップ1:合図でブロック
ひとつの方法は、ファイターの前に対戦相手を置いて打たれるままにし、ブロックを自分で見つけるのを待つことでした。しかし「打たれるのは悪い」ということしか手がかりがなければ、強化学習のエージェントはムエタイのブロックよりも、妙なびくつき方を発明してしまう可能性のほうが高いのです。そこで学習は2段階に分けました。まずは合図でのブロックです。ボタンがどのブロックかを指示し、体を動かすニューラルネットワークである方策(ポリシー)が、それを素早く上げ、倒れずに保つことを学びます。次にボタンをなくして対戦相手を入れ、同じ方策がどのブロックをいつ使うかを自分で決めます。
ボタンが押されている間、ブロックする腕のモーター目標はそのブロックのポーズに切り替わります。報酬は、速さ(ポーズのカバーの90 %に達するとボーナス、0.15秒以内なら満額)、静止して保つこと、上げる途中で肘を曲げたままにすること(大きく振って読まれやすくなるのを防ぐトニーのルール)、そしてガードへの滑らかな戻りに支払われます。脚と体幹には、これまでどおり構えの報酬がかかります。
ファイターは、すでに知っていることを忘れてはいけません。トニーのルールはこうです。「これまでの技はどれも絶対に忘れないようにしてください。バランスの取り方も、すべてのパンチも、歩き方も覚えたままでいること」。学習のエピソードの半分はブロックで、残りの半分は歩きの環境そのまま、つまり歩きとパンチです。ブロックのボタンが押されていない間は、歩きモデルの凍結したコピーが教師として働きます(方策蒸留)。そして、技能ゲートに合格するまではどのモデルも採用しません。条件は、テストのパンチ120回中58回以上、歩きの目標40個中39個以上を転倒なしで、それぞれ約8.3秒以内に達成することです。
4つのうち3つのブロックはすぐにできました。左ハイブロックだけは、15 Mステップ経ってもカバーできませんでした。3回のランでその理由がわかりました。
- ポーズは参照の構えをもとに作られていましたが、学習したファイターは胸が約8°多くひねられ、7°多く後ろに傾いて立っていました。その体幹ですべての関節をポーズの角度ぴったりにしても、ブロックは設計上のカバーの82 %しか覆えませんでした。そこで、ボタンを押すたびに、逆運動学を使って腕を実際の頭の位置に合わせるようにしました。
- それだけでは変わりませんでした。方策はすべてのモーター目標に自分で小さなオフセットを加えていて、ガードの癖で左肩が約4°低く、8°内側に入っていました。そのため腕はポーズから3.9 cmずれたままでした。肘と手首をポーズに引き寄せる報酬を加えても、10 Mステップでその癖は抜けませんでした。
- うまくいったのは、癖を弱めることでした。ブロックを上げている間は、ブロックする腕に対する方策のオフセットを30 %しか反映させないようにしたのです。4.6 Mステップで4つのブロックすべてがカバーでき、以前の技もすべてゲートに合格しました。
次は、ハイブロックが遅すぎるという問題でした。左が0.26秒、右が0.21秒です。そのブロックで、ファイターの左肩は53°から129°まで振られます。各関節は位置サーボで動かされていて、そのダンピング(速さに抵抗する部分)が、振り始めて20 msで引く力を打ち消していました。これは学習ではどうにもなりません。ハイブロックを上げている間だけダンピングを4分の1に弱めると解決しました。左0.12秒、右0.08秒、フロント0.10秒、ローフロント0.07秒で、どの押下でもカバーでき、パンチと歩きも合格したままでした。
ブロックは間に合うのか
対戦相手を入れる前に、ひとつ数字で確かめておくべき問いがありました。そもそもブロックは間に合うのでしょうか。
対戦相手はファイター自身です。ファイター自身の速いパンチ(ジャブ、クロス、左右のフック、アッパーカット)を一度記録し、それを物理演算なしで正面から再生します。その記録から、各パンチの最初の目に見える兆候はいつか、そして拳はいつ当たるのかを調べました。
ファイターは相手を画像として見ているわけではありません。16個のキーポイント(頭、首、肩、肘、手首、拳、腰、膝、足首)を、それぞれ自分の頭からの3Dベクトルとして、速度と40 msおよび80 ms前の短い履歴付きで見ています(フレームスタッキング)。しかも遅れて見えます。トニーは視覚の遅延を100 msにしました。速いプロ選手くらいの値です。さらに、見えなくなることもあります。両目から各キーポイントへ光線を飛ばし、ファイター自身の腕が邪魔をしていればその点は隠れます(オクルージョン)。
| パンチ | 最初に動く部分 | 当たる時刻 | 猶予 | 当たった時点のカバー* |
|---|---|---|---|---|
| ジャブ | 肘と拳、0.083秒 | 0.187秒 | 0.10秒 | 0.50(ガード:0.48) |
| クロス | 肘、0.079秒 | 0.220秒 | 0.14秒 | 0.68 |
| 左フック | 拳、0.110秒 | 0.342秒 | 0.23秒 | 0.82 |
| 右フック | 肘、0.106秒 | 0.343秒 | 0.24秒 | 0.69 |
| アッパーカット | 拳と肘、0.081秒 | 0.235秒 | 0.15秒 | 0.79 |
* 最初の動きから100 ms後に反応した場合に、拳が当たる時点で整っているブロックのカバーの割合。時刻は、ファイターには見えない「対戦相手がパンチを打つと決めた瞬間」から測っています。100 msの遅延があると、ジャブの0.10秒の猶予は、ファイターがパンチの始まりに気づく前に使い切られてしまいます。見えたものに反応するだけでは、全速のジャブに対してガード以上のことは何もできません。フックに対しては、ブロックの大部分を整える時間があります。
意外だったことがひとつあります。どのパンチでも、腰は腕より20〜60 ms後に動いていました。トニーは腰の回転を読みますが、これらのパンチでは最初の兆候は肘か拳でした。
この表をもとに、トニーはパンチごとの合格ラインを決めました。全速のパンチのうち止めなければならない割合です。ジャブ0.50(ガードを保つこと。ジャブに勝つには予測か距離が必要です)、クロス0.65、フック0.70、アッパーカット0.75。ダメージは部分的に数えます。拳の軌道のうち、腕に当たる前に頭や首に届いた割合です。
ステップ2:対戦相手
ここでボタンをなくし、方策には自分で操作する4つの新しい出力を与えました。ブロック1つにつき1つです。パンチは次々と来ますが、その間には0.5秒から2秒、対戦相手が構えたまま動く時間があります。トニーはこれをスローコンビネーションと呼んでいます。「1発ずつ順番に来るので、本当のコンビネーションではありません」。対戦相手の速さはカリキュラムで上がっていきます。パンチは50〜60 %の速さから始まり、ファイターが合格するにつれて最高速度が上がります。
ファイターに自分からブロックさせるだけで、3回のランがかかりました。探索(出力に加えるランダムなノイズ)によってボタンが1〜2ステップのうちに上がったり下がったりするので、ランダムな押下では腕が動く前にブロックが解除されてしまいました。そこで、押下は最低0.25秒そのブロックを保つようにしました。次に、学習中の滑らかさの項(CAPS)がボタンを平らにしてしまっていました。押下とはまさに出力の急な跳ね上がりだからです。ボタンをこの項の対象から外しました。3回目のランで、ファイターはブロックしました。
ファイターはどのパンチに対してもローフロントブロックを上げ、しかも対戦相手がパンチを打つ前に上げていました。
癖という手がかり
ファイターはパンチを読んでいたのではありません。もっと安上がりな手がかりを見つけていたのです(ショートカット学習)。そしてこれは4回起こりました。
- パンチの直前に相手が動き出していた。 パンチとパンチの間、対戦相手は固まって立っていて、記録した各パンチは押下の0.18秒前から構えの動きで始まっていました。つまり、どのパンチの直前にも相手がぴくっと動いていたのです。そこで、各パンチの前に2秒間の構えの動きを付けて対戦相手を記録し直し、決して静止しないようにしました。
- パンチごとに距離が違っていた。 これはトニーが見つけました。フックのときは相手が近くに立っていたのです。頭と頭の距離で、ジャブとクロスは0.78 m、右フックは0.62 m、左フックは0.52 m、アッパーカットは0.46 mでした。パンチを見分けるより、距離を見分けるほうが簡単です。
- 重なりが足りなかった。 パンチごとに距離をばらつかせても、部分的にしか隠せませんでした。すべてのパンチで同じ距離の範囲(0.57〜0.73 m)を使うことで解決しました。
- アッパーカットでは相手が低く立っていた。 各記録は相手の体の異なる高さに目標を置いていたため、アッパーカットをファイターの頭に合わせると、相手が4〜5 cm低く立つことになっていました。今はどのパンチでも相手の頭は同じ高さです。
その間に、ファイターのせいではない問題が2つ起きていました。ネットワークは、これまでに見た値の移動平均を使って入力をスケーリングしています(観測の正規化)。その平均はすべての入力で1つのサンプル数を共有していて、その時点で12億に達していました。後から追加した対戦相手の入力は、実際のばらつきが0.29や0.016しかないのに、初期値(平均0、ばらつき1)のままになっていたのです。5回のランの間、ファイターは対戦相手がほとんど見えていませんでした。ボタンは、相手が何をしようと、自分のリズムで0.75秒ごとに脈打っていました。平均を推定し直しても、まだ何も変わりませんでした。適切なボタンを押すことへの報酬(密なシェーピング報酬)は、シグナルとして弱すぎたのです。
うまくいったのは、直接教えることでした。対戦相手はスクリプトで動いているので、学習側はどのパンチが来るかを知っています。補助損失によって、パンチが見えている間は正しいボタンの出力を引き上げ、他のボタンを引き下げます。ブロックが得になるかどうかは、これまでどおりダメージで決まります。5 Mステップのうちに、ファイターはパンチごとに異なるブロックを上げるようになり、すぐに手がかり3と4を見つけました。
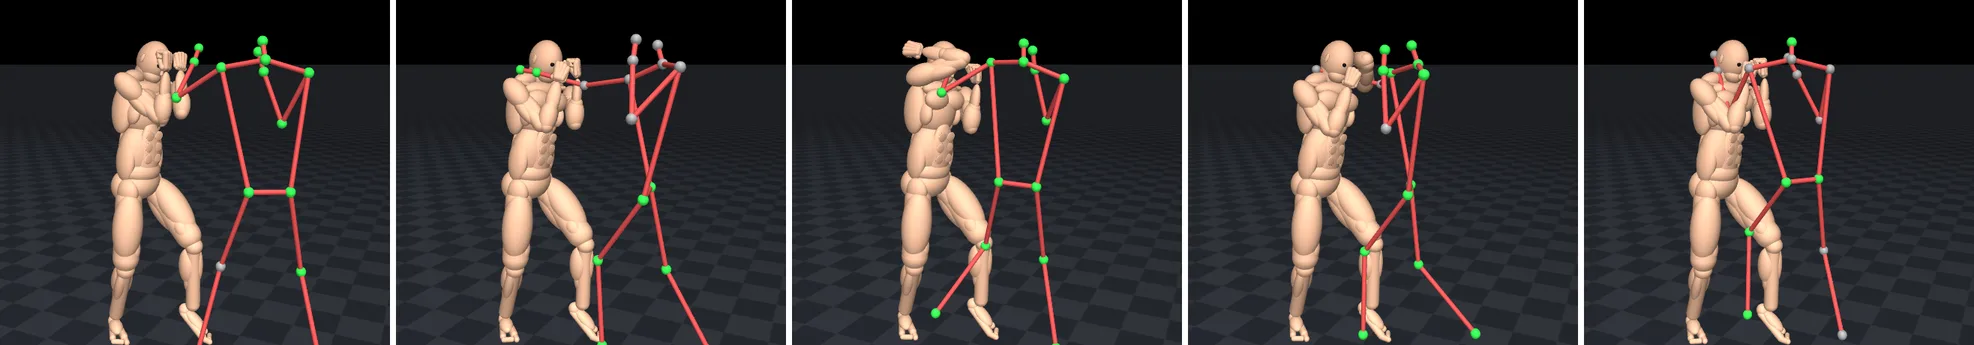
4つすべてを取り除いた、対戦相手との9回目のランで、ファイターは待つようになりました。相手が打つ前にはブロックしません。そして、ジャブとクロスにはフロントブロック、左フックには右ハイブロック、右フックには左ハイブロック、アッパーカットにはローフロントブロックを使い、ハイブロックは相手のパンチが始まってから0.24〜0.28秒で上がりました。パンチを読んでいることを証明する確認方法はこうです。相手のパンチを遅らせると、ファイターのブロックもそれに合わせて遅れます。
全速
パンチを読むことと、それを全速でやることは別の話でした。カリキュラムは、最高速度のパンチの80 %に合格して初めて速度を上げる仕組みでしたが、そこには一度も届きませんでした。23 Mステップの間、60 %より速いパンチは一度も学習されなかったのです。基準を60 %に下げると動き出し、全速ではテスト30回中21回に合格しました。その後の3回のランでは13〜19回で停滞しました。全パンチの4分の1を全速にしたランでも同じでした。
残っていたのは、時間の計算上読むのが間に合わないジャブと、右フックでした。ファイターの左ハイブロックは、オラクル(相手の最初の動きから100 msの遅延後に正しいブロックを押すスクリプト)より約0.1秒遅れていました。トニーが最初に考えたのは、左のブロックを速くすることでした。しかし先に測ってみると、遅くはありませんでした。ダンピングを弱めてもトルクを増やしても、ダメージはほとんど変わりませんでした。原因は推測のタイミングでした。パンチを見分けられるようになる前(開始から約0.22秒)、右ハイブロックのボタンは半分上がった状態で浮いていました。左フックだろうという推測です。右フック12回中3回で、左のボタンが上がる直前にその推測どおり押してしまい、0.25秒の保持のせいで間違ったブロックがフックの間ずっと上がったままでした。そこで、保持の間でもブロックを別のブロックに切り替えられるようにしました。待たなければならないのは解除だけです。追加の学習なしで、これだけで右フックの合格は12回中3回から5回になりました。
最後のランでは、各距離で実際にどのブロックが効くのかを調べました。5つの距離で、どのパンチに対してもすべてのブロックを早めに上げて構えておくと、「パンチ1つにブロック1つ」というルールは2か所で間違っていることがわかりました。アッパーカットに対しては、0.59〜0.65 mでフロントブロックなら7〜12 %しか通さないのに、ローフロントブロックでは43〜68 %通してしまいます。0.68 m以上からのジャブには、フロントブロックより左ハイブロックのほうがよく止めます。今は報酬が、各距離で測定上最もよいブロックを教えるようにしています。14.5 Mステップで全速は30回中24回に達し、これまでで最高でした。ジャブは6回中6回、アッパーカットも6回中6回です。
現在の到達点
採用されたモデルの、技能ゲートのテスト結果です(各速度でパンチごとに8回)。
- 対戦相手に対して: 160回中117回合格、全速では40回中31回、転倒なし。その前にゲートを通ったモデルは160回中78回でした。
- 合図でのブロックも健在: 32回の押下すべてでカバー(左ハイ0.12秒、右ハイ0.08秒、フロント0.11秒、ローフロント0.07秒)。押されても同様です。
- 以前の技も維持: パンチ120回中61回、歩きの目標40個中40個を転倒なし。ただし歩きは遅くなりました。目標1つあたり8.45秒で、8.3秒の基準をわずかに超えています。すべての基準に合格しているその前のモデルを、予備として残しています。
まだできないこと:
- 遠い距離からの右フック。 パンチの前から上げておいても、0.73 mからの右フックは、左ハイブロックで約0.44が通ってしまいます。これらのフックはほぼ正面から始まり、肘と拳の間をすり抜けてこめかみに当たります。トニーの形の範囲内でより良いポーズを探しても、ほとんど改善しませんでした(止められる軌道が0.77から0.79に)。肘はもう届く限界にあります。別の形が必要で、それはトニーが決めることです。
- 中距離のアッパーカット。 0.61〜0.65 mでのフロントブロックは、まだ半分しか身についていません。
- ジャブの大半。 学習時の距離では、ジャブ12回中7回が合格します。
コーチ・トニーの考え
トニーの指摘で一番面白いのは、フロントブロックについてのものです。
とても面白い点がひとつあります。エージェントがずっとフロントブロック、つまり前腕で顔を塞いでいると、実はペナルティを受けるんです。強化学習の罰によってではなく、手が顔の前にあると相手が見えなくなるという事実によってです。
ファイターの視覚はまさにそのように作られていて、それは意図的な選択でした。両前腕を顔の前に置くと、ファイターは前にいる対戦相手のテスト用の13点のどれも見えません(図1の4番目のポーズ)。拳も、肘も、肩も見えません。構えのガードでは10点、ローフロントブロックでは拳の間から13点すべてが見えます。見えないことに対する報酬の項はありません。そのコストは、本物のファイターにとってのコストと同じであるべきだからです。次のパンチが来て、それがどれだったか見えなかった、ということです。「見えない」ことへのペナルティを付けていたら、まずファイターはブロックしないことを覚えてしまったでしょう。(パンチが来ていないときにブロックを上げていると小さなコストがひとつあり、ずっと上げっぱなしにならないようにしています。)
トニーは、これが実際の試合からどれだけ遠いかもわかっています。パンチは1発ずつ、射程内に立ったまま決してフェイントをしない相手から来ます。ラン中に声に出して考えていたことでは、ジャブの届かない距離にいて相手が踏み込まなければならないようにすれば、その踏み込みが手がかりになる。リズムに合わせて頭を動かせば、速いジャブも外せる。相手の癖、リズム、得意なコンビネーションを覚える。そのどれも、このモデルにはまだありません。それでも今のファイターは、遅れて、部分的に見えない状態で対戦相手を見て、相手の立ち位置ではなく相手の動きからブロックを選んでいます。
数字で見る道のり
| ラン | 変更点 | 結果 |
|---|---|---|
| block1 | 合図でのブロック。エピソードの半分は歩きとパンチ。歩きモデルを教師に | 3つのブロックは動作。左ハイブロックはカバーできず |
| block2 | 押下のたびに腕を頭に合わせる | 左はまだ5〜13 %しかカバーできず |
| block3 | 肘と手首をポーズに引き寄せる報酬 | ガードの癖が残る |
| block4 | ブロック中は方策の腕のオフセットを30 %に | 4つすべてカバー、すべての技を維持 |
| block5 | ハイブロックを上げる間はダンピングを弱く | 左0.12秒(0.26から)、右0.08秒 |
| opp1 | 対戦相手、キーポイント、100 msの遅延、本当の死角。ファイター自身のボタン | ブロックを保てたことが一度もない |
| opp2 | 押下を0.25秒保持 | 滑らかさの項がボタンを平らにする |
| opp3 | ボタンを滑らかさの項から外す | 自分でブロックするが、手がかり1と2から |
| opp4 | 相手が決して静止しない。距離を重ねる | 手がかりは消えた。ガードのみ |
| opp5 | 適切なボタンへの報酬 | 変化なし。入力スケーリングのバグを発見 |
| opp6 | 対戦相手の入力をスケーリングし直す | 変化なし |
| opp7 | ボタンへの補助損失 | パンチごとにブロックするが、相手の距離から読んでいる |
| opp8 | 距離の範囲を1つに | パンチごとに正しいブロック。アッパーカットは相手の高さから読む |
| opp9 | 頭の高さを1つに | パンチを読む。60 %より速い速度では一度も学習せず |
| opp10 | カリキュラムの基準 80 % → 60 % | 全速 21/30 |
| opp11 | 学習バッチを大きく(速度テスト) | 学習は同程度。その後学習器のバグで破棄 |
| opp12 | opp11の最後の正常なモデルからやり直し | 全速は横ばい、13〜15/30 |
| opp13 | パンチの4分の1を全速に | 全速は横ばい、15〜17/30 |
| opp14 | 保持中にブロックを切り替え可能に | 19/30。採用 |
| opp15 | 各距離で効くブロックを報酬で教える | 24/30、93/120:採用 |
学習をより速く、より安く
ブロックのランは、学習用マシンをチューニングした1日でもありました。学習ランでは、2つの側が同時に動いています(分離型PPO)。ワーカープロセスは、何百もの環境のコピーでファイターをシミュレーションして経験を集めます。ラーナープロセスは、直近の経験のバッチを使ってネットワークを更新します。遅いほうの側がペースを決め、もう一方の側のプロセッサは待つことになります。
筋肉の体は、自分の拳に時間を浪費していました。 パンチのランをプロファイリングすると、物理ステップあたり38の接触があり、そのうち31.6は体が自分自身に触れているもので、ほぼすべてが拳の中の指同士でした。指は方策が動かしているわけではありません。モーターが指を拳の形に保っていて、そのポーズでは指の形状が少し重なっているため、物理演算は毎ステップ約25の接触を無駄に解いていたのです。それぞれの手のパーツ同士の接触を切ると、ステップあたりの接触は12.5になり、物理ステップは1.8倍速くなりました(742から412 µs)。パンチはこれまでどおり当たります(拳の速さ4.06 m/s、以前は4.12 m/s)。この「muscular-fast」の体は、4回目の対戦相手ランからすべてのランのデフォルトになりました。手を開いて掴まなければならない、後の組み技では使えません。
GPUはまだ役に立ちません。 レンタルしたGPU(vast.aiのGTX 1080、1時間約$0.06)は、ファイターを1920×1080で0.4秒でレンダリングしたので、動画には役立ちます。しかし学習は小さなネットワークではなく、CPUで動く物理演算を待っています。物理演算をGPUに移すにはすべての環境を書き直す必要があり、筋肉の体の63本の卵形の筋肉は、GPUシミュレーターとの相性がよくありません。vast.aiの大きなCPUマシンも、ステップあたりではEC2のc8aスポットマシンより安くありませんでした。
まずはマシンを大きく、次にコードを速く。 朝、スポットの上限が192 vCPUに引き上げられ、9回目の対戦相手ランはc8a.48xlargeに移りました。192コアで1時間$3.83です。96 vCPUのマシンの1.4倍のステップを、2.4倍の価格で実行しました。時間の約70 %、ワーカーはラーナーを待って遊んでいました。そこでコードを1つずつ変えていきました。
- 共有メモリ。 ネットワークの重みと集めた経験は、パイプを通してプロセス間で送られ、1つのコアがコピーして詰め直していました。今はすべてのプロセスが同じメモリから読みます。1時間あたり44 → 50 Mステップ。
- ラーナーを2つから4つに、ワーカーは144。1時間あたり60 M。7つの構成を試したところ、どれもラーナーで頭打ちでした。ラーナーを増やすと計算は速くなりますが、そのぶん各更新で合意を取るのに余計な時間がかかります。
- 学習バッチを2倍に。 更新あたりの合意の回数が減ります。ネットワークの学び方が変わるので、トニーはまずこれだけを単独でテストすることに同意しました。8 %速くなり、ステップあたりのファイターの学習はほぼ同じでした。
- 各ラーナーが自分のバッチの担当分を準備するようにしました。以前は1つのコアが全部を準備して配っていました。1時間あたり70 Mで、同じマシンで朝より59 %速くなりました。最初の版にはバグがありました。3つのラーナーが、ワーカーがすでに詰め直し始めているバッファから自分の担当分を準備していたため、各バッチの4分の3が間違っていたのです。9 Mステップ分の学習を捨て、今では学習器への変更はすべて最初の更新で確認するようにしています。
一番安いマシンはどれか。 速いことは安いことではありません。新しいコードでは、96 vCPUのc8a.24xlargeが1時間あたり50.5 Mステップを実行し、ワーカーの稼働率は85 %で、バランスの取れたマシンでした。1時間$1.87なので、100万ステップあたり$0.037です。192 vCPUのc8aは1.35倍速いものの、コアの半分がまだラーナーを待っていたため、100万ステップあたり$0.055でした。192コアのm8aは1時間あたり64 Mで、c8aとほぼ同じ速さでした。c8iのマシンは各コアを2つのハードウェアスレッドに分けるので、そこでの「vCPU」はコアの半分です。同じvCPU数のc8aに比べ、c8iのシミュレーションは約1.45倍遅くなりました。トニーは速さよりコストを選び、最後の2回のランは96 vCPUに戻しました。空き容量も重要でした。その日の午後、192 vCPUのマシンは2時間で3回回収されました。
かかった費用
ほとんどの学習ランでは、Amazon EC2のc8a.24xlargeを使いました。96 vCPUのマシンで、us-east-1のスポットインスタンスとして1時間約$1.4〜1.9で借りています。空き容量がないときは、起動スクリプトがc8iかc7aの同じサイズに切り替えました。途中の5回のランでは192 vCPUのマシンを使いました(上記)。Amazonはマシンを13回回収しました。各ランはチェックポイントを頻繁に保存しているので、新しいマシンで止まったところから続けられました。夕方近くにはスポットの空き容量が完全になくなり、最後の2回のランは1時間約$4.15のオンデマンドマシンで終えました。
| 項目 | マシン時間 | 費用 |
|---|---|---|
| 学習ラン20回 | 約13 | 約$30 |
| 技能ゲート9回、パンチの記録、距離別ブロックの表、ベースラインテスト(小さめのマシンで) | 約3.5 | 約$2 |
| 192 vCPUでの学習構成の速度テスト1回 | 約0.2 | 約$0.80 |
| 合計 | 約17 | 約$33 |
これらは請求書からではなく、各ランの開始・停止時刻とその時点の価格から見積もったものです。
次は
ファイターは対戦相手を見て、読める単発のパンチをブロックできるようになりました。次に必要なのは、トニーが挙げたものです。1発目のあとに来る、より速い2発目。これがあれば、目を覆うことに代償が生まれます。フェイント。相手のリズムや癖を覚えるための、0.1秒より長い記憶。そして何よりも距離です。射程の外に出て、相手が踏み込まなければならないようにすること。その踏み込みが手がかりになります。