
コスト · GPU · 学習速度
レンタルGPUで学習する:4.5倍安く
学習コスト 約$5マシン5台(ベンチマークとテスト)、約9.1マシン時間 · 内訳
これまでの記事では、ファイターはすべてAmazon EC2の、96または192vCPUのスポットマシンで学習してきました。この先どうなるかについて、コーチのヤム トニーはこう話しています。
EC2のスポットインスタンスで仮想CPUをどんどん増やしているので、コストがかさんできています。しかもこれはまだ始まりにすぎません。学習させることはまだまだたくさんあって、ネットワークも大きくなるかもしれない。だから高くなる一方です。お金を節約する方法を考えましょう。
GPUは選択肢の1つですが、接触の数や体の作りのせいで、いくつか厄介な点があります。だから実験が必要です。そう、コストを節約するために、実験にさらにお金をつぎ込むことになります。でも、それはいい投資になると私は思っています。
というわけで、この記事は新しい技についての記事ではありません。技を学ぶためのマシンについての記事です。レンタルのGPUのほうが学習が安く済むのか、そのためにコードをどう変える必要があったのか、そしてどのGPUがいちばん安いのか。ここで学習したモデルは捨てました。大事なのはタイミングと請求額だけでした。
扱うのは10月21日の朝、04:05から07:54 UTCまでです。
GPUが当たり前の答えではなかった理由
ブロックの記事では、レンタルGPUを数分試して見送りました。学習は物理演算を待っていて、その物理演算はCPUで動いていたからです。GPUが役に立ったのは小さなネットワークの部分だけでした。
それを回避する方法は、物理演算もGPUに移すことです。MuJoCo WarpはMuJoCoのGPU版で、何千もの世界のコピーを同時に、足並みをそろえてシミュレーションします。ただ、このファイターには2つの落とし穴があります。
- 体。 筋肉の体は、骨盤から指の関節の1つ1つまで、1本の木構造に89の自由度があり、その上に63本の卵形の筋肉が載っています。GPUシミュレーターは、関節が数十個程度のロボット向けに作られています。シンプルな体(図1の右)は43です。
- 接触。 CPUでは、世界のコピーそれぞれが必要なだけの接触を保持できます。GPUでは、どのコピーも学習の開始前に決めた固定数の枠を割り当てられます。倒れたあと、床に横たわる筋肉の体は、接触が32、拘束の行(物体どうしがすり抜けないように物理演算が解く方程式)が260に達します。枠が小さいとあふれてランがクラッシュしました。うまくいく大きさの枠だと、ほとんどの時間、メモリの大半が空いたままになります。
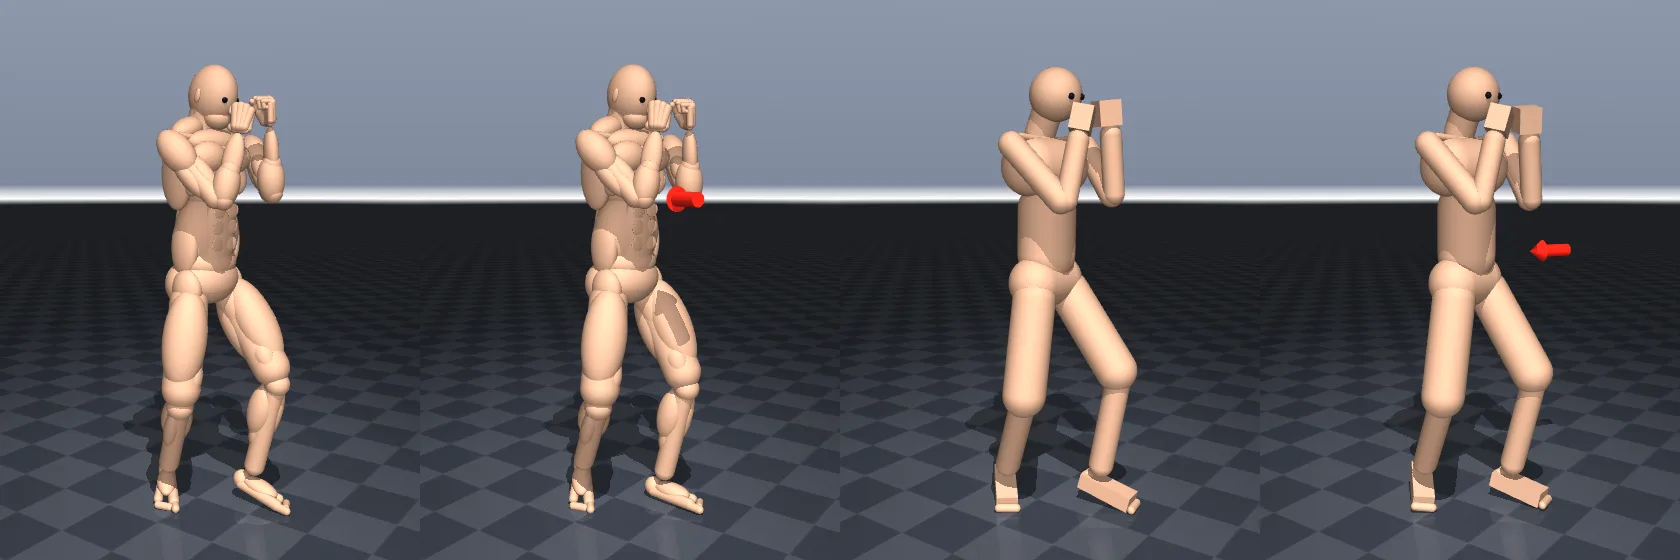
テスト
タスクは、ファイターが最初に学んだものです。構えで立ち、リズムを保ち、押されても倒れないこと(バランスの記事)。各マシンで、解けるまでゼロから学習させました。解けたとみなす条件は、振幅が最大、転倒で終わるエピソードが5%以下、そしてエピソードが10 sいっぱい続くことです。体はmuscular-fastとsimpleの両方を試しました。
どのマシンでも2つの数字を記録しました。解けるまでの時間と、その時間にマシンの1時間あたりの価格を掛けた1回解くあたりのコストです。
どちらの側も、多数の世界のコピーを同時に学習させます(並列環境)。CPU側は、いつもの学習プログラムを使った普通のEC2スポットのランを2回行いました。72個のワーカープロセスに、それぞれ6つのコピーです。
| マシン | 体 | 価格 | 解けるまでの時間 | コスト |
|---|---|---|---|---|
| c8i.24xlarge スポット、96 vCPU | muscular-fast | $1.45/h | 714 s | $0.29 |
| c8a.24xlarge スポット、96 vCPU | simple | $2.02/h | 404 s | $0.23 |
ステップ1:1台のGPUに合わせてコードを調整する
最初のGPUは、最新の一般向けカードであるRTX 5090で、vast.aiで1時間$0.74で借りました。vast.aiは、個人や小さなデータセンターがGPUマシンを秒単位で貸し出すマーケットです。
GPUの学習プログラムは2日前に書いたもので、古いカードでテストしていました。5090では、4,096個の世界のコピーで毎秒44,000〜47,000ステップを回し、GPUの使用率は97%でした。時間の10分の9は物理演算が占めていました。
遅い部分を見つける。 プロファイリングで、GPUが実行する小さなプログラム(1つ1つがカーネル)すべての時間を計りました。1つが時間の53%を占めていました。質量行列の分解です。質量行列は、各関節に付いているものすべてを考えたときに、その関節がどれだけ動かしにくいかを表す表です。MuJoCo Warpには、自由度64までの体向けの速い方法があります。筋肉の体の89自由度は、すべて1本の木構造にあるため、遅い汎用の方法に回されていました。1回の分解につき、木の階層ごとに1回ずつ、24回の別々の起動が必要で、それが物理演算の1ステップごとに2回あります。
置き換え。 新しい版(warp_factor.py)では、世界のコピーそれぞれに64本のGPUスレッドのグループを割り当て、分解全体を1回の起動で行います。階層の間では、新しいカーネルを始める代わりに、スレッドどうしが互いを待ちます。長い和は8個ずつの塊に分け、1本のスレッドだけが全部の仕事をすることがないようにしました。分解にかかるGPU時間は1ステップあたり38.6 msから8.9 msになり、物理演算は28%速くなりました。8,192個のコピーで毎秒76,000ステップです。物理演算そのものは同じです。同じエピソードで同じ行動をとらせると、関節角度は標準の方法と100万分の1ラジアンまで一致しました。32ビットの数値で可能な限りの近さです。
シンプルな体にはこれは必要ありませんでした。43自由度なら、MuJoCo Warpの速い方法に収まります。
そして意外なこと:世界のコピーが少ないほうが学習が速い。 新しい分解と8,192個のコピーで、GPUは毎秒61,000ステップ、CPUマシンの5倍の速さで学習しました。それでも12分たって、ファイターは完全な構えの60%にしか達していませんでした。CPUマシンはそれより短い時間で解いていたのにです。
理由はカリキュラムにあります。構えが広くなるたびに、次に広がるまで決まった数の学習イテレーション、世界のコピー1つにつき約2エピソード分を待ちます。1イテレーションでは、すべてのコピーを32ステップ進めます。つまり、どのマシンでも解くには約350〜500イテレーションかかり、解けるまでの時間はその数に1イテレーションあたりの秒数を掛けたものになります。コピーを増やしても、1イテレーションが長くなるだけです。学習が最も速いのは、GPUを忙しくさせておける最小限のコピー数のときで、5090ではそれが1,024でした(図2)。
1,024個のコピーになると、GPUはもう仕事不足ではありません。待っているのです。物理演算の1ステップに含まれる何千もの小さなカーネルには、それぞれ決まった起動コストがあり、1,024個のコピーでは、計算ではなくそのコストがペースを決めます。そこで次の変更では、待ち時間を削りました。
ステップの途中でCPUに問い合わせない。 「どれかのコピーが倒れたか?」のようなコードは、CPUを止めてGPUの答えを待たせます。転倒、リセット、押す動作、足にかかる力を、マスクを使ってすべてのコピーを一度に処理するよう書き直し、学習プログラムは1イテレーションに1回だけGPUから数値を読むようにしました。
1,024個のコピーでのmuscular-fastは、5090では毎秒31,000〜32,000ステップのままでした。このマシンでは物理演算が限界だったのです。待ち時間が効いてきたのは、次のマシンたちでした。
ステップ2:9種類のGPU
スクリプト(vast_bench.py)で、GPUの種類ごとに最も安い出品を同時に借り、コードをコピーし、同じ速度テストと、体ごとに2分間の学習を行ってから、マシンを返しました。9種類で、2018年のデータセンター向けT4の1時間$0.15から、RTX PRO 6000の$1.00までです。
1回目の結果は期待外れでした。5090以外のどのマシンも、ネットワークの更新に1イテレーションあたり0.7〜1.4 sかかり、5090は0.2 sでした。5090はたまたま、新しく速いプロセッサを積んだデスクトップに入っていたのです。レンタルGPUの多くは、遅くて古いプロセッサのサーバーに入っていて、学習プログラムはそれを待っていました。ここでは5090とほぼ同じくらい速いカードであるL40Sが、毎秒13,000ステップしか学習できませんでした。
そこで、CPUをループから外しました。
- ネットワークの更新をCUDAグラフに。 ミニバッチでの1回の学習ステップ(ネットワークを実行し、勾配を求め、クリップし、重みを更新する)を一度記録し、1つの単位として再生します。CPUが何百ものカーネルを1つずつ送る必要がなくなりました。1イテレーションあたり0.6〜0.7 sが0.2 sになりました。
- 物理演算を含む環境のステップ全体もCUDAグラフに。 これ単独では5%だけでした。
- 8回の参照を1回に。 参照モーション(構えのリズムの中で各関節がどこにあるべきか)は8つの表になっていて、1ステップに3回、1つずつ参照していました。物理演算以外にかかる1ステップの21 msのうち、8 msがこれでした。今は表を横に並べ、1回の参照ですべてを読みます。物理演算以外の作業は8.7 msに減りました。これと、シンプルな体の接触の枠を半分にしたこと(足にかかる力のチェックはすべての枠を読みます)によって、RTX 3090でのシンプルな体は毎秒41,000ステップから48,000ステップになりました。
途中で2つのバグが見つかりました。1つは、どのランも最初のステップを2回シミュレーションしていたことです。1回はGPUのコードを準備するため、もう1回は本番です(害はなく、今は修正済み)。もう1つは、倒れた筋肉の体が折り重なって、拘束の枠が足りなくなったことが一度ありました。上で述べた2つ目の落とし穴です。枠を320行から512行に増やしましたが、コストの増加は測れないほどで、どれかのコピーの枠が足りなくなると学習プログラムがOVERFLOWと表示するようにしました。
新しいコードで調査の2回目(図3)を行うと、普通のサーバー用プロセッサの後ろにあるカードも、本来の速さを出しました。最も安い2つについて、別の国の別のマシンで2回目のテストをしても、1イテレーションあたりの秒数は数%以内で同じでした。
ステップ3:GPU対EC2
全体の一覧です。1回解くあたりのコストはセットアップ込みです。「~」は推定した時間を示します。
| マシン | 場所 | $/h | muscular-fast | $ | simple | $ |
|---|---|---|---|---|---|---|
| RTX 5080 | vast.ai | 0.39 | 515 s | 0.065 | 230 s | 0.034 |
| L40S | vast.ai | 0.44 | 452 s | 0.065 | 227 s | 0.038 |
| RTX 3090 | vast.ai | 0.20 | 1163 s | 0.070 | 451 s | 0.030 |
| RTX 4090 | vast.ai | 0.51 | 436 s | 0.074 | 217 s | 0.043 |
| RTX 5090(最速) | vast.ai | 0.69 | 377 s | 0.089 | 185 s | 0.053 |
| T4 | vast.ai | 0.15 | 2326 s | 0.100 | 1025 s | 0.046 |
| L4 | vast.ai | 0.36 | 1074 s | 0.117 | 389 s | 0.048 |
| A100 | vast.ai | 0.46 | 931 s | 0.129 | 403 s | 0.062 |
| g6.xlarge (L4) | EC2 スポット | 0.48 | ~1074 s | ~0.167 | ~389 s | ~0.076 |
| g6e.xlarge (L40S) | EC2 スポット | 1.47 | ~452 s | ~0.259 | ~227 s | ~0.167 |
| c8a.24xlarge、96 vCPU | EC2 スポット | 1.34 | 714 s | 0.299 | 404 s | 0.184 |
| c8a.48xlarge、192 vCPU | EC2 スポット | 3.65 | ~529 s | ~0.627 | ~299 s | ~0.394 |
ここからわかること:
- レンタルの一般向けGPUは、4分の1以下の価格で構えを解きます。muscular-fastでは、96 vCPUのスポットマシンの$0.30に対して、RTX 5080かL40Sで$0.065。simpleでは$0.18に対して$0.03〜0.04です。しかも速いのです。5080、L40S、4090はCPUマシンの55〜70%の時間で、5090は約半分の時間で解きます。
- 最も安いカードどうしは、互いに約15%以内の差です。RTX 5080、L40S、RTX 3090、RTX 4090です。3090は1時間あたりでは最も安いものの、速さは半分以下です。5090は最速で、1回解くあたり約30%高くなります。お金より時間が大事なときには、その価値があります。
- データセンター向けのカードは、ここではコスパが悪いです。 A100、L4、T4は大きな行列計算と大量のメモリ向けに作られていますが、この物理演算は何千もの小さなステップでの普通の32ビット演算です。求められるのはクロック速度で、メモリやテンソルコアではありません。
- EC2自身のGPUマシンは割に合いません。 同じL40Sでも、EC2ではvast.aiの3.4倍かかります。その中で最も良いL4付きのg6.xlargeでも、1回解くあたりのコストはCPUマシンの約半分ですが、CPUマシンより遅いです。
- シンプルな体は、GPUではコストが約半分です。1秒あたり1.7倍のステップを回し、必要なイテレーション数はほぼ同じです。CPUでは差は1.3倍にすぎません。
マシンの準備
1イテレーションあたりの速さだけで請求額が決まるわけではありません。レンタルマシンは、学習を始める前の、起動した瞬間から料金がかかります。vast.aiでは、ソフトウェアのイメージをダウンロードする時間は無料ですが、コードのコピー、物理演算ライブラリのインストール、GPUコードの準備は通常の料金がかかります。
最初はコピーが遅いものでした。スクリプトはプロジェクトのファイルをすべて送っていて、それが57 MB、そのうち51 MBは歩きの環境だけが使う表でした。そして安いホストの多くは受信回線が遅いのです。カリフォルニアのA100は受け取るのに17分かかり、その後同じ回線でライブラリのインストールに26分かかりました。今はスクリプトが送るのは1.4 MBで、500 Mbit/s以上のホストを指定しています。良いホストなら有料のセットアップは約1.5分、1〜2セントで、EC2のCPUマシンが起動から最初のイテレーションまでにかかる時間(75〜93 s)とほぼ同じです。
本当のリスクは悪いホストです。タイのRTX 4090は、2回とも、別の4090の10分の1の速さでしか動きませんでした。RTX PRO 6000は起動したものの応答せず、何もせずに$0.51かかりました。あるRTX 5080はドライバーが古すぎてGPUコードが動かず、自分のカードを認識できませんでした。今はスクリプトが新しいドライバーを指定し、5分以内に応答しないマシンは諦めるようにしています。
コーチ・トニーの考え
この朝のトニーの指示は、まずGPUコードをマシンに合わせて最適化し、それから比較することでした。両方の体で、他のGPUマシンも試して最も安いものを見つけ、EC2とも比べる。トニーはこの実験を、お金を節約するために使うお金、「いい投資」と呼んでいました。モデルは捨ててかまわないものでした。
最初の調査結果が戻ってきたとき、トニーはなぜアップロードがこんなに遅いのかと尋ね、学習時間だけでなくセットアップのコストも比較に入れるよう求めました。57 MBのアップロードと、悪いホストによる損失が明らかになったのは、そこからでした。
次にやること
今のところGPUで動くのは構えだけです。パンチ、歩き、ブロック、そして対戦相手のいる環境は、それぞれEC2から移る前に専用のGPU版が必要です。この数字なら、その作業はすぐに元が取れます。前回の記事のブロックの20回のランは、EC2で約$33かかっていました。
かかった費用
コストの大部分は、GPUを測るために借りた費用と、比較用のEC2でのCPUのラン2回です。どちらのランも、解けたあと数分間そのまま動かしていました。vast.aiの金額はvast.aiの課金記録から、EC2の金額は各ランの時間とスポット価格から出した推定値です。
| 項目 | マシン時間 | コスト |
|---|---|---|
| vast.aiのRTX 5090:プロファイリング、新しい分解、世界のコピー数のテスト、シンプルな体 | 約1.7 | 約$1.21 |
| vast.aiのRTX 3090:CPUをループから外す作業と、ゼロからのラン2回 | 約1.1 | 約$0.22 |
| 調査:2回の調査と時間を計った再実行で、約17台のGPUマシン | 約5.5(推定) | 約$2.61 |
| EC2スポットのラン2回(c8i.24xlargeとc8a.24xlarge、96 vCPU) | 約0.8 | 約$1.38 |
| 合計 | 約9 | 約$5.40 |