
ムエタイ · フットワーク · 歩き · 報酬設計 · コーチング
フットワーク:ムエタイの構えのまま目標地点へ歩く
学習コスト 約$35学習ラン22回、約26.5マシン時間 · 内訳
速いパンチの記事の終わりまでに、ファイターはガードから5種類のパンチを、素早く、指示通りに打てるようになっていました。しかし、どれも同じ場所から打っていました。動けないファイターは、いつ間合いに入るかを選べません。
コーチのヤム トニーは、こう言います。
距離のコントロールは、打撃系の格闘技で最も重要な要素の1つです。まだ攻防が続くくらいには近く、でも相手に打たれるほどには近くない距離にいたい。打撃の技にはそれぞれ少しずつ違う間合いがあって、相手にも相手の間合いがあります。だから、距離をいちばんよく理解している人が、大きな優位に立てるんです。
この記事は、そこへ向けた最初の一歩、フットワークについてです。パンチを当てるために急に踏み込むことや、パンチをかわすために素早く下がることではありません。それはもっと先の話です。ここで扱うのは、ラウンドの序盤に2人のファイターが互いの様子を探り合うときの、ゆっくりした動きです。良いムエタイの構えのまま、前、後ろ、横、斜めに動き、ピボットで向きを変えます。
扱うのは、10月18日17:34 UTCから10月19日の夜までの25時間にわたる22回の学習ランです。採用したモデルの学習が終わったのは、10月19日15:44 UTCでした。
課題:目標地点と向き
ファイターには目標が与えられます。前足の母指球を置く床の上の地点と、向くべき方向です。ファイターは構えのままそこへ行き、落ち着かなければなりません。地点はどこにでもありえます。前、後ろ、横、あるいは真後ろで、振り向いてそちらを向くよう指示されることもあります。
パンチと同じように、動きは参照モーション、つまり物理演算を含まないアニメーションから始まります。今回のものは、トニーが構えのまま歩く28秒の動画から作りました。前へ、後ろへ、カメラの方を向くピボット、また前と後ろ、そしてピボットで元に戻る、という内容です。その動画から、1歩ずつのステップのライブラリを作りました。体の周り16方向で、それぞれ1歩いっぱい(前に26 cm、後ろに22 cm、横に20 cm)までの任意の大きさのステップと、左右に向きを変えるピボットです。前に進むときは、前足が先に踏み出して母指球で着地し、後ろ足が低く続きます。後ろに下がるときは、後ろ足が先に動きます。各ステップは、ファイターが構えの中で行う穏やかな体重移動であるリズムの1拍に合わせてあるので、歩きも他のすべての動きと同じ拍子を保ちます。足と腰の位置は台本で決めてあり、関節の角度は逆運動学で求めます。
次にどのステップを踏むかは、何かが決めなければなりません。それがシンプルなプランナーで、ビデオゲームでキャラクターを動かすものと似ています。各拍の始めに、目標がどこにあるかを見ます。向きが30°以上ずれていればピボットします。そうでなければ、どの方向であれ、地点に向かってまっすぐ、そこに着地する大きさでステップします。体を動かすニューラルネットワークである方策(ポリシー)は、ときどき押されながら、計画された各ステップを、本物の筋肉と重力を使った本物のステップに変えなければなりません。
そして、パンチを忘れてはいけません。最も良いパンチのモデル、速いパンチの記事のモデルを凍結したコピーが、教師になります(方策蒸留)。ファイターが歩いていないときは、新しい方策は教師の行動に引き寄せられます。歩きは自由に変わってよく、パンチは変わるべきではありません。
教訓1:体重の乗った足はピボットでひねれない
各ランは、パンチのモデルから始めて、直前のモデルから学習を続けました(ファインチューニング)。最初のランはステップを覚えましたが、8.8 Mステップの学習の間、ピボットで体を回したことは一度もありませんでした。8回続けてピボットしても、腰は45°のうち0°しか回りませんでした。
参照モーションでは、体重が乗ったまま前足を母指球で回していました。本物の足ならキャンバスの上でそれができますが、シミュレーションの足と床との接触は、ひねっても滑りません。それに、前の腰は、地面に着いた足の上で45°回ることはどのみちできません。参照モーションは、体にできないことを求めていたのです。
2回目のランでは、別のピボットを使いました。体重をすべて平らにした前足に乗せ、地面に着いた足の上で腰を回しながら、後ろ足を持ち上げて回し、後ろ足を着地させ、それから前足を少し上げて向きを直します。1拍につき30°です。6 Mステップのうちに、ピボットで1回に21〜23°回るようになりました。ところが今度はステップが機能しなくなり、前足がほとんど動かなくなりました。歩きへの報酬が単純に小さすぎたのです。目標に26 cm近づいても1拍あたり約0.5しかもらえず、良い構えを保つと1拍あたり約50もらえました。3回目のランでは歩きへの報酬を数倍に強くし、ステップはゆっくりと戻ってきました。
教訓2:筋肉には前もって伝える
ステップは着地するようになりましたが、短いものでした。前へのステップは計画した距離の4%、横へのステップは20%未満しか進みませんでした。2つの変更でその大半が直りました。
各関節は位置サーボで動きます。関節を目標の角度へ引っ張るモーターです。サーボは、動き続ける目標に対して遅れます。そこで、歩きのサーボの目標を、その遅れの分だけ参照モーションより先に進めました。一種のフィードフォワードで、筋肉には脚が今どこにあるかではなく、どこにある必要があるかを伝えます。また、学習エピソードの30%を、ステップの途中から、参照モーションの姿勢と速度で始めるようにしました(参照状態初期化)。これで方策は、ステップの始まりだけでなく途中も練習できます。
1回のランのあと、ステップは後ろへは計画の92%、前へは58%、横へは56%進むようになりました。8つのテスト目標のうち6つに到達しました。外れた2つは、地点から10〜15 cmのところをぐるぐる回り、小さなステップで行き過ぎていました。プランナーを変え、一度到達した地点は到達したままとみなすようにしました。それ以降、テスト目標には8回中8回すべて到達し、転倒もありませんでした。
教訓3:パンチを忘れない
その頃にはファイターは約100 Mステップ歩いていて、パンチのテストは何かが失われたことを示していました。パンチのモデルは自分のテストで60回中38回当てていましたが、歩くモデルは20回でした。教師の引き寄せ(重み2)では、パンチがずれていくのを許してしまっていたのです。
教師の重みを10に上げても効果はなく、その理由はバグでした。ニューラルネットワークは、それまでに見たものの移動平均を使って、入力を標準的な範囲にスケーリングして受け取ります(観測の正規化)。教師には、生徒の平均でスケーリングした入力が与えられていて、その平均は歩きのデータが入ってくるにつれてずれていました。教師の助言は、モーター1つあたり約0.007、ときには0.025ずれていました。小さな値ですが、パンチを外させていた差と同じくらいの大きさでした。少し間違った助言にもっと強く引き寄せても、何も直りません。教師に自分自身のスケーリングを使わせると、パンチは戻ってきました。
テストそのものにも欠陥がありました。各テストでは、ファイターのリズムの6つの瞬間に、それぞれのパンチを6回押していました。しかし歩きの環境は乱数を別の順序で引いていたので、6回の押す瞬間が違うところに当たっていました。そして6回だけだと、スコアは大きく揺れます。パンチのモデル自体も、自分の環境では38回なのに、歩きの環境では60回中19回でした。瞬間を固定し、パンチごとに20回押すようにすると、パンチのモデルは200回中112回、修正後の歩くモデルは107回でした。修正前の低下は本物でしたが、30ポイントではなく約10ポイントでした。
教訓4:報酬ではなくステップで舵を取る
歩きはどの目標にも到達しましたが、遅く、目標1つあたり約7.5 sかかりました。ステップを1つずつ測ると、時間がどこに消えていたかがわかりました。腰が1ステップごとに3〜10°ずれていき、それは方向ごとにいつも同じ向きで、やがて向きが大きくずれてピボットが必要になり、ピボットのたびに前足が5〜13 cm動いていたのです。
最初の修正では、報酬だけで1ステップあたり最大10°舵を取るようファイターに求めました。ファイターはそれを覚えず、遅くなりました。参照モーションの関節角度はまっすぐのステップのままだったので、姿勢を合わせることへの報酬が腰をまっすぐに保っていたのです。2つ目の修正では、舵取りを参照モーションに入れました。32個の新しいステップで、それぞれ普通のステップをしながら、足が空中にある間に左右どちらかに10°回ります。これはすぐにうまくいきました。前へのステップは本来の長さ(以前の17〜22 cmに対して27〜28 cm)に達し、目標1つにかかる時間は7.4 sから6.7 sになりました。
ここでトニーはもう1つ求めました。後ろにある目標の方を向くために、ぐるっと一回りすることも学習に含めるようにしてほしい、ということです。それはすでに含まれていました(学習の目標の約11%は150°を超える回転が必要でした)が、今度は振り向くのがいちばん時間がかかるようになっていました。約33°のピボットを5〜6回です。そこで左のピボットを60°回るようにし、腰の回転の半分を地面に着いた前足の上で、残り半分を着地した後ろ足の上で行うようにしました。右のピボットは30°のままにする必要がありました。右に回ると、足が腰を越えて回った途端に、後ろの腰の回転の余地がなくなってしまうからです。プランナーは、ピボットの回数が少なく済む方へ回ります。その場での180°の回転は5.9 sから3.5 sになりました(図2)。
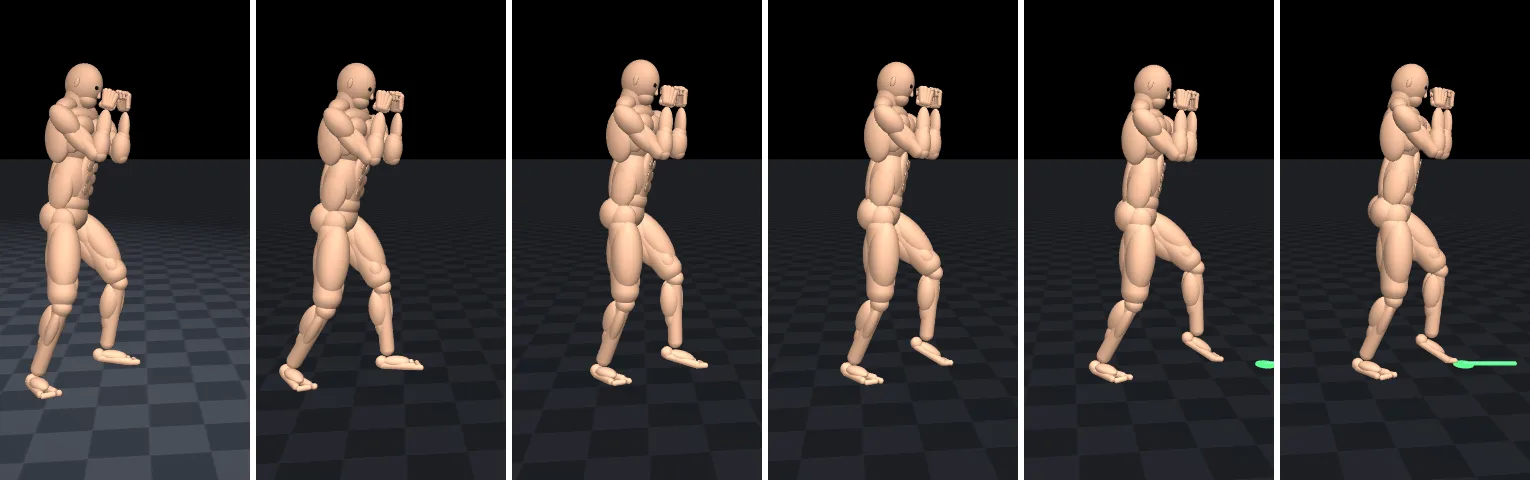
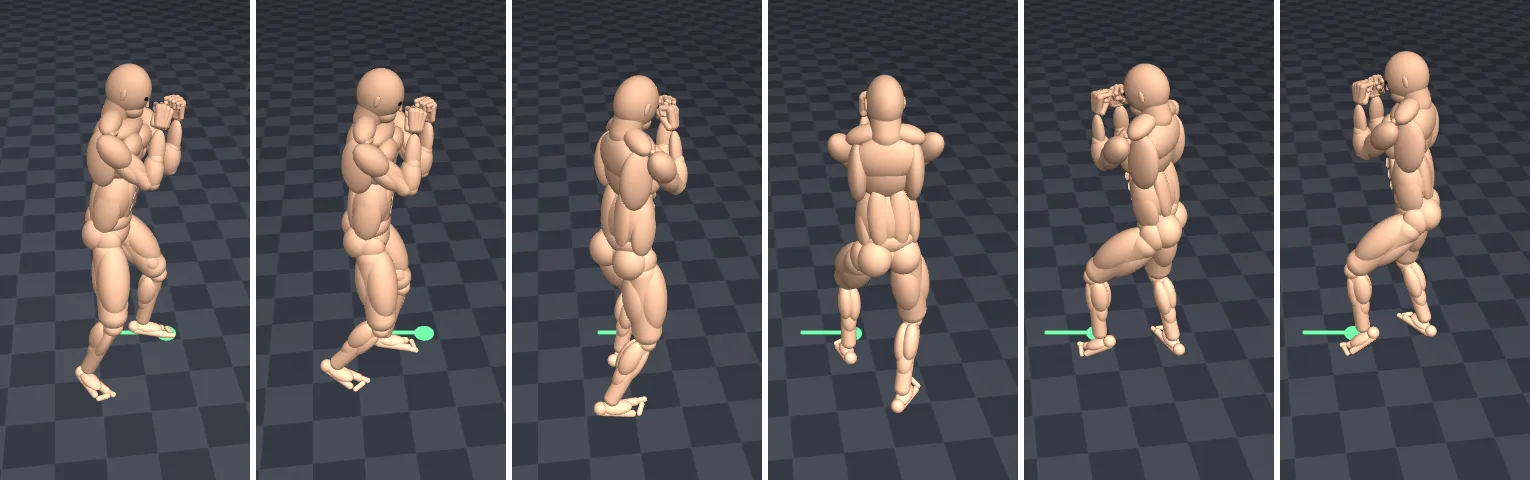
教訓5:トニーのスタイルを見る目
この時点で、歩きは機能していました。40個のテスト目標(10種類の目標を4回ずつ、押す動作あり)すべてに平均6.09 sで到達し、地点から5.4 cmのところに着地し、パンチも保たれていました。そこでトニーが、コーチとしてそれを見ました。
1歩ごとにムエタイの構えに戻ってしまう……歩きは歩きのモードのままにして、構えと歩きを行ったり来たりしないようにしてほしい。
トニーの言う通りでした。参照モーションのどのステップも、構えで静止した状態から始まって静止した状態で終わり、各ステップの約4分の1は、どちらの足も動いていませんでした。そこで各ステップを4つの版に分けました。動き出し、流れるように通過、到着、そして1歩だけのステップです。歩き続けるとき、ファイターは構えで止まらず、構えを通過するようになりました。それでも腰は構えのたびに歩く速さの約4分の1まで遅くなったので、次のランでは床の上での腰の速さに報酬を出しました。それでも変わりませんでした。理由に先に気づいたのはトニーでした。
1歩ごとにまた構えに入ってしまう……後ろ脚に70%、前に30%くらい体重が乗っているみたいな感じ……理想を言えば、構えはまったくなくて、ステップからステップへ移るだけがいい。
参照モーションそのものが、2歩ごとの間に、後ろ足に69%という構えの体重配分に戻っていたのです。そこで歩きの途中からは構えを取り除き、流れるようなステップの間の体重を50/50にしました。それから、トニーの指摘が1つずつ続きました。
- 「後ろ脚がよく引きずられていて、それでモデルがつまずくことさえある。」足をもっと高く上げるようにし、床から離れることに報酬、床をこすることにコストを付けました。
- 「まずかかとが上がって、それからつま先がついてくるべきで、空中ではつま先が垂れ下がるのではなく足が平らになっているべき。」後ろ足は空中で水平になるようにしました。足首は、体の後ろで足を完全に平らに保てるほどは曲がらないので、そこに近づけるために足をもっと高く上げました。
- 「まだ後ろ足に体重が重く乗っているのと……前脚のかかとが床から浮いているのが見える。」前足のかかとは、ステップの間、床に着いたままにしました。
- 「歩いていく目標地点は、そんなに正確でなくていい……パンチそのもので少しの距離は調整できるはず。」目標は、8 cmと8°以内ではなく、15 cmと15°以内で到達とみなすようにしました。
変更のたびに、歩きはトニーの歩き方に近づきました。そして変更のたびに、歩きは難しくなりました。後ろ足を高く上げることで、1歩1歩がバランスとの戦いになり、方策はステップを短くすることで応えました。そして、
足を引きずっているように見える……前脚の方にほとんど傾いていて、体まで左に傾いている。
まだかなり足を引きずっている。斜め前にお辞儀しているみたいで、胴体が曲がっている。
新しい報酬の1つは、それぞれの足に正しい割合で体重が乗っていることに支払うものでした。ファイターが前足に体重を乗せる方法は、その上に身を乗り出すことでした。お辞儀です。構え本来の前傾より平均8.2°、最大16°余分に傾いていました。これは報酬ハッキングの教科書的な例です。ファイターは意図されたことではなく、数字が求めることをしました。次のランではその報酬を外し、胴体をまっすぐに保つことへの報酬を加えました。お辞儀はなくなりました(平均4°)が、ファイターはそれを使って体重を移していたのです。それがなくなると、左へ踏み出せなくなりました。
斜めのステップがまったくおかしい。前に出たり後ろに下がったりを繰り返すだけで、実際には前に進んでいない。
左へのステップは、計画の20 cmのうち9〜15 cmしか進まず、体重の90%以上が後ろ足に残っていました。ファイターは地点から約28 cmのところで止まってしまいました。プランナーが十分近いとみなす25 cmのすぐ外側です。そして前足を前後に小刻みに動かしていました。腰が参照モーションの軌道に沿うことへの報酬をもう1つ加えると、さらに悪くなりました。40個中17個です。
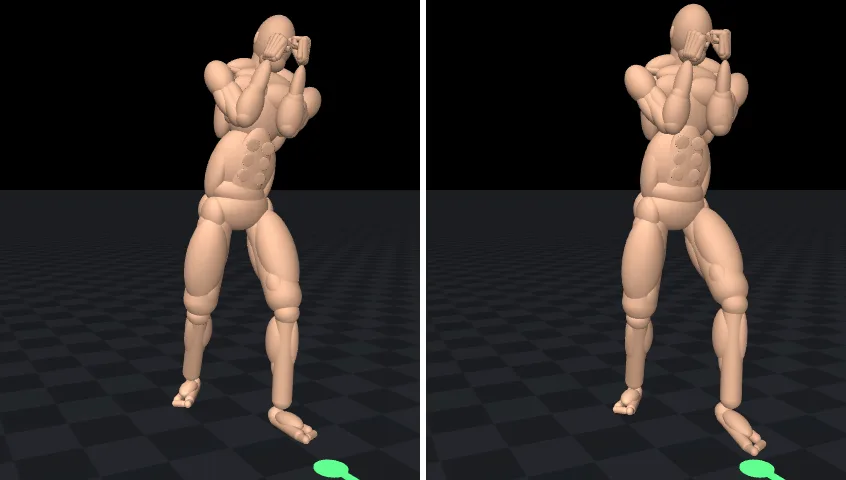
機能優先
トニーが決断しました。
よし、見た目についての要求は全部外そう。目標まで歩くことがいちばん大事。ただし、お辞儀はしないこと。
次のランは、スタイルの作業より前の、最も良い歩くモデル(40個中40個、目標1つあたり6.09 s)に、元の参照モーションとともに戻りました。見た目への報酬はすべて外しました。腰の速さ、足の高さ、床をこすること、体重の配分です。残したのは2つ、胴体をまっすぐに保つことへの報酬と、15 cmというゆるい到着条件です。
20.7 Mステップで、40個の目標すべてに転倒なしで、平均6.70 sで到達しました。前へのお辞儀は構えより平均2.8°、最大6.9°でした。12回押すテストでのパンチは120回中60回で、教師の修正以降のどの歩きのランとも同じです。これが、この記事で採用したモデルです。
最後のランでは、弱点である横へのステップを直そうとしました。まっすぐに保つ報酬は、横へのステップに必要な小さな横への傾きも含め、どんな傾きもお辞儀と数えていました。そこでそのランでは、横への傾きは許し、前への傾きだけを禁じました。するとどの方向でもステップが短くなり、40個中38個の到達でした。ステップを妨げていたのは横への傾きではなかったのです。
コーチ・トニーの考え
トニー自身のまとめです。
スタイルよく歩くことを学ぶのは、とても難しいとわかりました。ムエタイの構えのように1歩ごとに脚を上げていたのが、足を引きずるようになり、前脚に体重をかけすぎ、後ろ足を引きずるようになりました。でも、スタイルについての制約を加えれば加えるほど、歩きは悪くなっていきます。だから、スタイルと実際に役立つ動きとの間には、バランスがあるんです。
数字が示しているのも同じことです(図4)。トニーの指摘はどれも妥当なコーチングのポイントで、ファイターは実際に求められた通りに変わりました。しかし新しいルールが加わるたびに、同時に満たすべきものが1つ増えます。それも、押されながら倒れずにいることとパンチを保つことで、すでに手いっぱいの体の上にです。ルールのたびに少しずつ速さか届く距離が失われ、そのうち2つは歩きを壊しました。
今のところは機能が勝ちます。ファイターは地点にたどり着き、まっすぐ立って、パンチを打つ準備ができています。トニーはまた、到着は正確である必要がないとも指摘しました。パンチそのもので距離と方向を少し調整できるからです。スタイルはあとで、機能する歩きの上に、1つずつルールを戻していけばいいのです。
現在の到達点
採用したモデルを、40個の目標で、押す動作ありでテストした結果です。
- すべての目標に到達、転倒なし: 目標1つあたり平均6.70 sで、地点から7.8〜13 cmのところに着地(15 cm以内で到着とみなす)。
- 振り向くのが速い: その場での180°の回転は約3.7 s。1 m後ろの目標に振り向いて向くのは約8.5 s。
- まっすぐ: 構えを超えた前後の傾きは平均2.8°で、6.9°を超えることはありません。足を引きずるモデルは平均8.2°、最大16.3°でした。
- パンチは保たれた: 120回中60回。出発点のパンチのモデルは約56%です。
弱点は横へのステップです。横へのステップは計画の20 cmのうち10〜11 cmしか進まないので、より多くのステップが必要になります。0.8 m横の目標には7.3〜8.3 sかかり、1.2 m前(7.6 s)とほぼ同じです。また、トニーが批判した歩き方のままでもあります。ステップの間で構えの方へ戻ってしまい、後ろについていく足は低く、かかとが上がったまま振られます。
ここまでの道のりを数字で
| ラン | 変えたこと | 結果 |
|---|---|---|
| walk1 | 目標地点と向きへ歩く。パンチのモデルを教師に | ステップは機能。ピボットは0°:参照モーションが体重の乗った足をひねっていた |
| walk2 | 地面に着いた前足の上でピボット、1拍につき30° | ピボットを習得。ステップが止まる |
| walk3 | 歩きへの報酬を数倍に強化 | ステップがゆっくり着地し始める |
| walk4 | サーボのフィードフォワード。エピソードの30%をステップの途中から開始 | ステップが計画の56〜92%に到達。目標6/8 |
| walk5 | 一度到達した地点は到達したまま(ぐるぐる回らない) | 目標8/8、転倒なし。パンチがずれていく |
| walk6 | 学習率を下げ、着地を厳しく | 8/8を9〜11 s、5〜8 cmで |
| walk7 | 教師の重み 2 → 10 | 停止:教師が間違った入力スケーリングを使っていた |
| walk8 | 教師に自分自身のスケーリング | パンチが戻る(112に対して107/200)。目標1つあたり7.4 s |
| walk9 | 報酬で舵を取る | 習得できず、遅くなる |
| walk10 | 参照モーションに舵取りステップ | 目標1つあたり6.7 s、本来の長さのステップ |
| walk11 | 60°の左ピボット | 180°の回転が3.5 s。目標1つあたり6.3 s |
| walk12 | 構えを通過して歩き続ける | 40/40、6.09 s。構えで腰がまだ遅い |
| walk13 | 腰の速さに報酬 | 変化なし:参照モーションがまだ構えで止まっていた |
| walk14 | ステップの間に構えなし。足を上げ、こするとコスト | 流れるような歩き。足はまだこする |
| walk15 | 後ろ足を空中で平らに、7 cm上げる | ステップが短くなる、7.1 s |
| walk16 | ステップの間、前足のかかとを下ろす | 7.4 s。後ろ足に体重が乗る |
| walk17 | 15 cm以内で到着。体重配分への報酬 | 6.7 sだが、足を引きずりお辞儀する |
| walk18 | 胴体をまっすぐにする報酬。体重配分は外す | お辞儀なし。左へ踏み出せず、32/40 |
| walk19 | 腰の軌道に報酬 | 悪化:17/40 |
| walk20 | 以前の横へのステップに戻す | walk21のため5分後に停止 |
| walk21 | walk12の歩き。直立以外の見た目の報酬なし | 40/40、6.70 s、お辞儀なし:採用 |
| walk22 | 横への傾きを許す | ステップが短くなる、38/40 |
かかった費用
学習ランはすべて、Amazon EC2のc8a.24xlarge 1台を使いました。96vCPUのマシンで、us-east-1で1時間$1.48〜1.80のスポットインスタンスとして借りたものです。そのタイプに空きがないときは、起動スクリプトが同じ世代の同じサイズ(c8i)に、一度は1つ前の世代(c7a)に切り替えました。1時間に33〜38 Mステップのシミュレーションを回しました。Amazonはラン中にマシンを5回取り上げました。どのランも1分ごとにチェックポイントを保存するので、そのたびに新しいマシンで止まったところから続け、失ったのは数分でした。
| 項目 | マシン時間 | コスト |
|---|---|---|
| 学習ラン22回 | 約19 | 約$29 |
| 小さなマシンでのテストと表作成のジョブ約30件 | 約5 | 約$2 |
| 学習の構成の速度テスト2回(1回は2時間止まったまま) | 約2.4 | 約$3.50 |
| 合計 | 約26 | 約$35 |
テストは別の小さなマシンで行ったので、学習用のマシンが評価のために止まることはありませんでした。速度テストの1つで、学習の作業を2つに分けると4%速くなることがわかり、それ以降のすべてのランでそれを使っています。これらは請求書からではなく、各ランの開始・停止時刻と、その時点のスポット価格から出した見積もりです。
次にやること
この歩きで、ファイターは必要な場所へたどり着けます。ただ、まだトニーの歩き方のようには見えず、横への移動も遅いです。まだ試していないアイデアが2つあります。ファイターが実際にできることに計画を合わせるために横へのステップを短く計画すること、あるいは目標1つあたりのステップ数をもっと許すことです。
次の技は、すでにこのモデルの上に積み上げられています。ブロックの学習はこのモデルから始まり、歩き、構え、パンチをすべて同じ種類の教師で保っています。ファイターが1つの体で、動き、打ち、守れるようにするためです。