
ニューラルネットワーク · モデルの容量 · 蒸留 · 生徒
ファイターの脳はどれだけ埋まっているのか:ネットワークサイズの実験
学習コスト 約$8学習ラン4回、約14マシン時間 · 内訳
要約。 AIファイターのレパートリー全体、つまり18の技と歩き、ブロック、ダッシュは、512個のニューロンの隠れ層を2つ持つひとつのニューラルネットワークに収まっています。重みにして約50万個です。最近は新しいスキルを覚えるたびに古いスキルがひとつ犠牲になっていました。これはネットワークが一杯になったときの典型的な姿ですが、教師同士が互いに逆方向へ引っ張り合っているときの姿でもあります。この2つを見分けるため、私はネットワークを3通りに大きくしました。幅を広げる(1024 × 2)、深くする(512 × 3)、その両方(1024 × 3)です。しかも動作がそれまでとまったく同じになるやり方で拡張し、それぞれを変更なしの512 × 2の対照と並べて、同じ2億ステップずつ学習させました。教師との近さ: 対照は7 %改善して頭打ちになりました。拡張したネットワークは20 %、24 %、41 %改善し、それは16の教師すべてで同じでした。最も大きいものは最後の時点でもまだ改善を続けていました。この尺度で見れば、小さいネットワークは容量の限界に達しています。戦いのテスト: 21のテストのどれでも、3つの大きなネットワークは対照よりはっきり良くも悪くもありませんでした。教師に近づいても、まだファイターが強くなったわけではありません。それでも私は、この先の作業のために最も大きなネットワークを採用しました。
スキルを交換してしまうネットワーク
ファイターは方策(ポリシー)です。1秒に50回、体やバランス、どの技のボタンが押されているかについての465個の数値を読み、48個の数値を出力します。すべての関節モーターの目標角度です。試すページにあるすべての動きは、生徒と呼ぶひとつのネットワークが担っています。生徒は方策蒸留で学びます。技ごとに教師、つまりその技だけを学習した別のネットワークがあり、生徒はその技が出ているときは対応する教師のように、それ以外のときはベースの教師(guard18。構え、パンチ、歩き、ブロック)のように動くよう学習します。10月の時点で、ひとつの生徒に16の教師を注ぎ込んでいました。
ここ数回の蒸留には、あるパターンがありました。この実験の直前の生徒であるdistill12は、その前の生徒よりブロックと蹴りが良くなった一方で、膝蹴りが悪くなり(ゲートのスコアが11から8に)、左の肘打ちも悪くなりました(52から49に)。それ以前の生徒にも、同じような交換が見られました。何かを忘れることでしか新しいことを覚えられないネットワークは、一杯になったネットワークの教科書どおりの症状です(その極端な形が破滅的忘却です)。ただ、ほかにも少なくとも2つの説明が考えられます。ひとつは学習の予算です(各ランは数時間なので、生徒はもっと長く学習すればよかっただけかもしれません)。もうひとつは教師そのものです。教師は別々に学習されているので、似た状況で両立しないことを求めることがあります。
ニューラルネットワークには計器がついていません。「83 %埋まっています」と表示してくれる目盛りはないのです。ですから、この問いには実験で答えるしかありません。同じ生徒により多くの余地を与え、それ以外は何も変えず、良くなるかどうかを見るのです。
実験の設計
4つのネットワーク、ひとつの出発点。 すぐに思いつく実験は、大きなネットワークをゼロから学習させることです。しかしそれでは、サイズと、生徒がすでに学んだすべてのこと、という2つを同時に変えてしまいます。そこで、どのネットワークも同じ関数から始めました。採用されていた生徒distill12-196.6Mを、関数を保つネットワークの拡張で大きくしたものです。
- 幅を広げる。 各隠れ層に512個の新しいニューロンを加えます。入ってくる重みは、ほかの新しいニューロンと同じくランダムです。出ていく重みはすべてゼロにします。新しいニューロンが何を計算しても、その先ではまだ誰もそれを読まないので、ネットワークの出力は元とまったく同じです。そのあとの学習が、新しいニューロンに役割を与えます。これはNet2Net(Chen et al., 2016)の幅の拡張を、コピーの代わりにゼロで行ったものです。
- 深くする。 出力の直前に新しい隠れ層を加えます。その重みは単位行列で、バイアスは+1です。ネットワークの活性化関数であるELUは正の入力に対しては恒等写像で、前の層の出力は常に−1より大きいので、+1を足すと新しい層への入力はすべて正になり、そのまま通り抜けます。出力層のバイアスが、余分な1を差し引きます。
学習を始める前に、実際の生徒で4096個のランダムな入力を使って確かめました。幅を広げた方策の出力は元と完全に一致し(最大の差は0.0)、深くしたものの差は4 × 10⁻⁵で、浮動小数点の丸め誤差の大きさでした。したがって、学習後に4つの間に違いが出れば、それはサイズによるもので、ほかの何によるものでもありません。
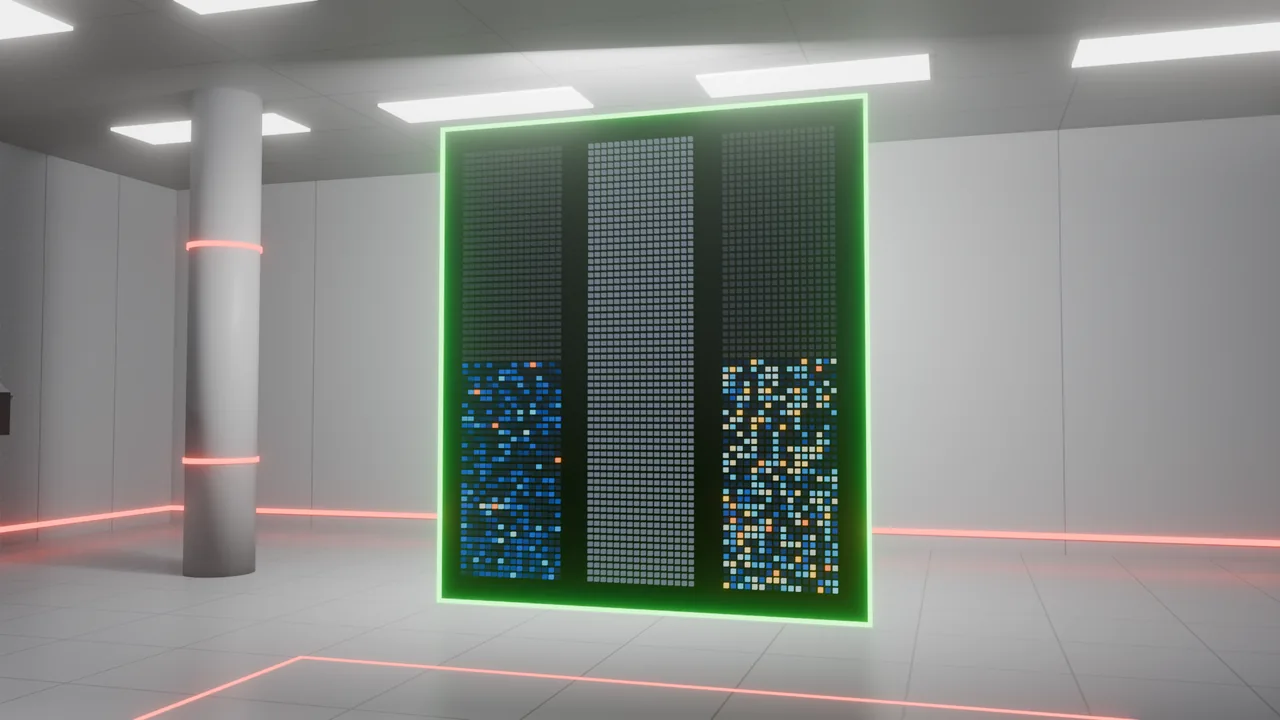
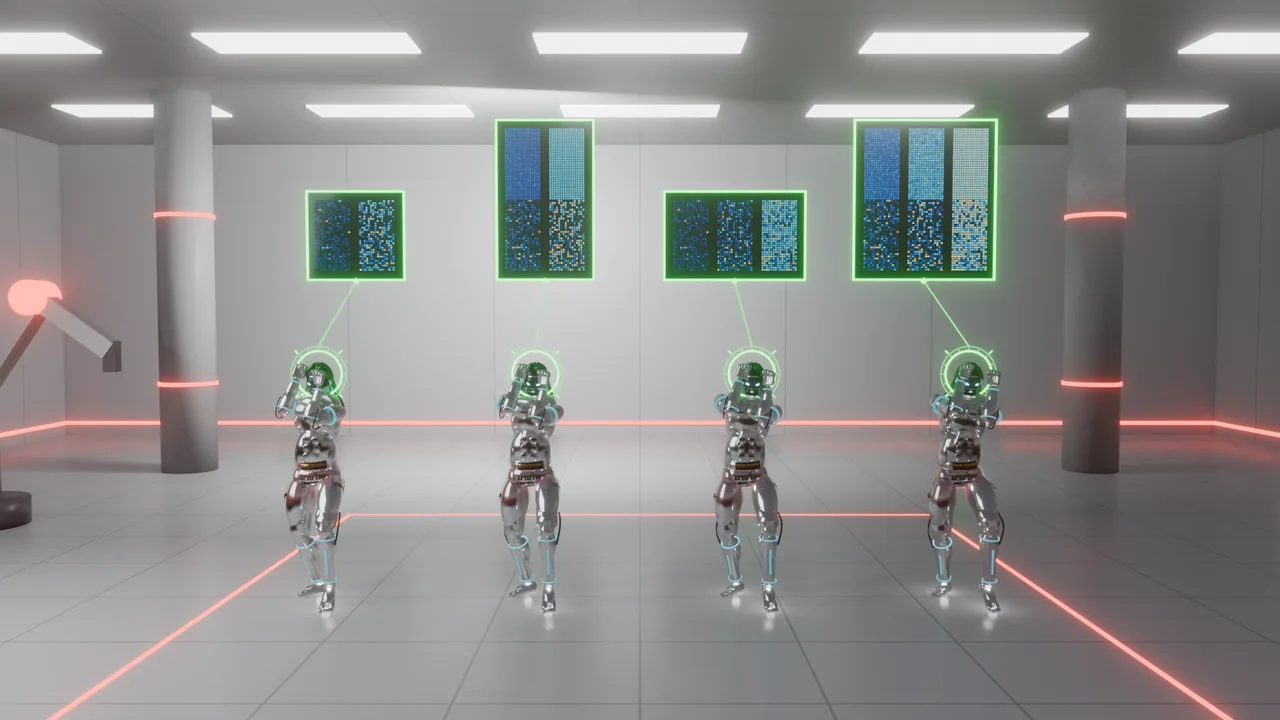
2 × 2の設計。 幅と深さを別々に、そして同時に変えたので、それぞれの効果を切り分けられます。
| ネットワーク | 隠れ層 | 方策のパラメータ数 | 相対的な大きさ |
|---|---|---|---|
| 512 × 2(対照、元のネットワーク) | 512が2層 | 525,872 | 1.0 |
| 1024 × 2(幅を広げた) | 1024が2層 | 1,575,984 | 3.0 |
| 512 × 3(深くした) | 512が3層 | 788,528 | 1.5 |
| 1024 × 3(両方) | 1024が3層 | 2,625,584 | 5.0 |
(クリティック、つまり状況がどれだけうまく進んでいるかを見積もる同じ形の2つ目のネットワークも同じように拡張していますが、ここでは数えていません。)
対照は、元のネットワークをほかとまったく同じように学習させたものです。これで「学習を増やすと良くなる」と「余地を増やすと良くなる」を切り分けられます。もし対照が拡張したネットワークと同じだけ改善するなら、生徒は単にステップ数が足りなかっただけです。
同じステップ数。 どのネットワークも、distill12の設定を一切変えずに、ちょうど2億環境ステップ学習しました。同じ環境、同じ重みの同じ16の教師、同じ学習率、同じ練習の配分です。大きいネットワークは1ステップあたりが遅いので、ステップ数を揃えると時間は揃いません。その費用は均さずに、下で報告します。
2つの尺度。 ひとつ目は、生徒が教師にどれだけ近づくかで、学習中ずっと教師ごとに記録しました。2つ目はゲートです。生徒の候補がすべて受ける同じ戦いのテストを、各ネットワークの最終チェックポイントで行いました。
教師との距離
学習中、毎回の更新の前に、トレーナーは生徒が直近のロールアウトで実際に訪れた状態を取り出し、それぞれの状態を担当する教師に、自分ならどうしたかを尋ねます。距離は、生徒の行動と教師の行動の平均二乗誤差を48個の関節指令で平均したもので、教師ごとに別々に記録します。
ここでは教師が担当する訪問済みの状態の集合、は生徒の行動(その確率的方策の行動分布の平均)、は教師の行動です。生徒自身の状態で測ることが大切です。教師が見たことのない状況に流れていった生徒は、教師の得意な場面ではなく、その状況で評価されます。以下では、距離を1000倍して示します。
結果1:大きなネットワークほど教師に近づく
| ステップ | 512 × 2 | 1024 × 2 | 512 × 3 | 1024 × 3 |
|---|---|---|---|---|
| 0–25 M | 4.60 | 4.66 | 4.87 | 4.91 |
| 50–75 M | 4.48 | 4.37 | 4.42 | 3.98 |
| 100–125 M | 4.43 | 4.03 | 4.03 | 3.33 |
| 175–200 M | 4.28 | 3.75 | 3.71 | 2.88 |
| 変化 | −7 % | −20 % | −24 % | −41 % |
目立つことが3つあります。
対照は限界に近い。 同じ学習をさらに200 Mステップ続けても、元のネットワークは7 %しか改善せず、最後には曲線がほぼ平らになっています。学習を増やすだけでは、この差は埋まらなかったでしょう。
幅と深さはほぼ同じだけ効き、両方を合わせると最も効いた。 1024 × 2は512 × 3の2倍のパラメータを持ちますが、同じところに落ち着きました(3.75と3.71)。パラメータあたりで見れば、層を1つ増やすほうがお得でした。両方を合わせると、どちらか一方よりも良くなりました。1024 × 3の改善(41 %)は、ほかの2つの和(20 % + 24 %)に近い値です。
拡張したネットワークは少し遅れて始まる。 最初の25 Mステップでは、大きなネットワークは対照より少しだけ教師から離れています(4.87–4.91と4.60)。まったく同じ関数から始めたにもかかわらずです。新しい重みは最初の更新から学習されますし、各重みのステップ幅をその重み自身の勾配の履歴に合わせて調整するAdamオプティマイザでは、新しい重みも古い重みと同じ速さで動きます。そのため、効果が出る前に、受け継いだ動きをしばらく乱してしまいます。これは私の解釈で、別に測ったものではありません。その代償は約10–20 Mステップです。
差はあらゆるところにある。 もし1つか2つの教師が対立していたのなら、余地が増えればその技だけが良くなり、ほかはそのままだったはずです。ところが実際には、1024 × 3は16の教師のうち15で対照より30–35 %近づいています。真似するのが最も難しい蹴り(距離5–7)から、膝蹴りやボディストレート(2–4)までです。最初からネットワークに入っていたベース、つまり構え、パンチ、歩き、ブロックも含まれます(0.30から0.21へ)。ベースの次にもともと簡単だったダッシュは、改善が最も小さく(20 %)なりました。すべての教師で一様な差が出るのは、2つの教師のいさかいではなく、余地の不足の姿です。
結果2:戦いのテストでは、はっきりした差はない
教師との距離は学習のための尺度です。大切なのはファイターがより良く戦えるかどうかで、それを試すのがゲートです。空中の狙いの点とサンドバッグに対するすべての技を6つのランダムシードで、パンチ120回、歩きの目標40個、ブロック32回、守るべき対戦相手からのパンチ160回、決められた60の距離からのパンチ、そしてボディストレート。各行は決まった試行回数のうちの成功数を数えるもので、探索のノイズなしで実行します。
各行について、ネットワークの成功率と対照の成功率の差を、95 %の信頼区間とともに求めました(Agresti–Caffoの区間で、行が0回や全回成功のときにも妥当に振る舞います)。空中の蹴りがすべて30回中30回のように、4つのネットワークが同じスコアだった行は除いたので、残りは21行です。
| 512 × 2との比較 | 良い | 悪い | 同じ | はっきり違う | 符号検定 |
|---|---|---|---|---|---|
| 1024 × 2 | 9 | 10 | 2 | 1(サンドバッグへの右アッパーカット、54回中3 → 11) | p = 1.0 |
| 512 × 3 | 8 | 8 | 5 | 0 | p = 1.0 |
| 1024 × 3 | 8 | 10 | 3 | 0 | p = 0.82 |
1024 × 3の行で、対照とはっきり違うものはひとつもありません。パンチ(120回中61と56)、空中でのプルカウンター(6回中6と3)、サンドバッグへのミドルキックと左ローキックでは上回り、ブロック(32回中24と26)、空中での膝蹴り、右の肘打ち、空中での左ハイキック(36回中23と30)では下回っています。1行ずつ見る代わりに行の数を数えると、8行で良く10行で悪いので、符号検定ではp = 0.82となり、どちらの方向にも証拠はありません。1024 × 2の「はっきり違う」1行は、偶然だけでも生じる程度のものです。21行で95 %区間を使えば、運だけで約1行は外れるはずだからです。
2つの尺度が食い違う理由
教師に41 %近づいたのに戦いは良くならないネットワークには、説明が必要です。確からしい順に4つの理由を挙げます。
ゲートにはこの大きさの差が見えない。 ゲートの行の試行回数は6回から160回です。成功率70 %前後で試行30回なら、差の95 %区間の幅は約±23ポイント、試行6回なら±50を超えます。1つの行で10ポイントの本当の改善を、通常の80 %の検出力で検出するには、ネットワークごとに約330回の試行が必要です。ゲートは、何かを壊してしまった生徒を見つけるために作られていて、その役目はよく果たします。しかし、どれも優秀な4つの生徒を順位づけるためのものではありません。
二乗距離は差を誇張する。 距離は二乗の平均です。その平方根、つまり1つの関節指令における典型的な差の大きさは0.065から0.054へと18 %下がるだけで、41 %ではありません。改善の大部分は、大きなネットワークが教師の大きくてまれな行動をよりうまく真似るようになったことによるもので、そうした行動は距離にとってほど、当たるかどうかには重要でないのかもしれません。
教師も完璧ではない。 戦いのテストが採点するのは生徒の結果です。膝蹴りは十分な速さで5 cm以内に当たったか。教師をより忠実に真似る生徒は、教師の失敗も受け継ぎます。教師が当てられるものを当てられるくらい近づいてしまえば、それ以上近づいてもほとんど得るものはありません。
200 Mステップではまだ早いのかもしれない。 ランを止めた時点で、1024 × 3の距離はまだ急に下がり続けていました。容量の利点が戦いのテストに現れるのは、近さの差がもっと大きくなってからなのかもしれません。
ですから、正直なまとめは両面あります。小さいネットワークは確かに容量の限界に達しています。学習の対象である尺度で見れば、学習を増やしても良くならなくなり、余地を増やすとすべてのスキルで良くなりました。しかし、その容量が今日のファイターの技を制限しているのかどうかは、この実験からは言えません。ゲートが見分けられる範囲では、制限していません。
かかった費用と使ったマシン
各ネットワークはvast.aiのレンタルRTX 5090でそれぞれ1台ずつ、4つ同時に学習しました。大きなネットワークは1ステップあたり遅くなりましたが、サイズの違いよりはるかに小さな差でした。各ステップの大部分を占めるのはネットワークではなく、体のシミュレーションだからです。
| ネットワーク | 1秒あたりのステップ数 | 200 Mステップにかかった時間 |
|---|---|---|
| 512 × 2 | 25,400 | 2.19 |
| 1024 × 2 | 23,900 | 2.33 |
| 512 × 3 | 24,100 | 2.30 |
| 1024 × 3 | 21,900(−14 %) | 2.54 |
5倍のパラメータで、学習速度は14 %落ちただけでした。サイズの影響が出るのはゲートです。ゲートは普通のCPUで方策を動かすので、1024 × 3のゲートは12コアで49分かかりました。ほかは16–32コアで30–45分です。ほかに7台のマシンを借りましたが、起動しませんでした(4分たっても接続できない、または10分たってもまだ読み込み中)。それらは数分以内に破棄し、ページ上部の費用に含めています。すべてのマシンは下の作業ログに載せています。
決定
私は1024 × 3、cap1024x3-200.0Mを、この先のすべての親として採用しました。ゲートを見る前に決めたルールは単純で、最も大きなネットワークにはっきり不利なものがゲートになければ、それを採る、というものでした。何もありませんでした。理由はこの先にあります。これからの数週間の計画では、このひとつのネットワークが抱えるべきものが増えます。動く対戦相手を狙うこと、打撃をつないでコンビネーションにできるよう次の技を待ち行列に入れておくこと、そして対戦相手がどこにいるかを見ることです。どれも同じ重みの中に入る新しい動きです。今あるすべてのスキルについて余地が十分にあるとすでに示したネットワークのほうが、それらを入れる場所としてふさわしいのです。
サイズだけで足りなかった場合に備えて、もっと大きな変更も候補にありました。小さなネットワークが複数の専門的なネットワークを混ぜ合わせることを学ぶ混合エキスパート(Peng et al., 2019)や、上位のコントローラーが選ぶスキルの空間を学習するもの(Peng et al., 2022)です。どちらもニューロンを足すよりはるかに大きな変更です。この実験は、それらがまだ必要ないことを示しています。
この実験の限界
- ネットワークごとにランは1本。 各サイズは1回しか学習していません。曲線は滑らかで、差はその揺れに比べて大きいので、距離の順位は信頼していますが、誤差棒をつけることはできません。
- マシンが違う。 4本のランは4つのホスト(フランス、ノルウェー、ベトナム、カナダ)で動きました。1秒あたりのステップ数には、ネットワークのサイズとハードウェアの違いが混ざっています。
- 計算量ではなくステップ数を揃えた。 1時間あたりで公平に比べるなら、小さいネットワークに約16 %多くステップを与えることになります。その曲線がどれだけ平らだったかを考えれば、それで33 %の差が埋まることはなかったでしょう。
- ゼロからの学習ではなく拡張。 この結果が示すのは、すでに学習済みの生徒に余地を足すとどれだけ役立つかです。最初から1024 × 3で学習したネットワークは、違うところに落ち着くかもしれません。
コーチとして思うこと
この実験は、10月31日に並行して走らせるよう私が頼んだいくつかのうちのひとつで、その週の大仕事であるコンボの狙いの計画の前に行いました。「並行して走らせられるステップをまとめて立ち上げてください。たとえば……ネットワークのサイズを大きくする必要があるのか、層を増やす必要があるのか」。戦いのテストの結果が出る前に、私はすでに「はっきり不利なものがなければ、1024x3でいきましょう」と言っていて、そのとおりになりました。
このページの冒頭にある短い映像を作ったとき、私が大切にしている問い、「AIの脳が一杯になったことはどうすればわかるのか」で始め、その答えが何のためにあるのかで終えたいと思いました。脳がさらなる学習に備えられた今、ムエタイの技がもっと増えていきます。
参考文献
- Agresti, A. and Caffo, B. (2000). Simple and effective confidence intervals for proportions and differences of proportions result from adding two successes and two failures. The American Statistician 54(4).
- Chen, T., Goodfellow, I. and Shlens, J. (2016). Net2Net: accelerating learning via knowledge transfer. ICLR.
- Peng, X. B., Chang, M., Zhang, G., Abbeel, P. and Levine, S. (2019). MCP: learning composable hierarchical control with multiplicative compositional policies. NeurIPS.
- Peng, X. B., Guo, Y., Halper, L., Levine, S. and Fidler, S. (2022). ASE: large-scale reusable adversarial skill embeddings for physically simulated characters. ACM Transactions on Graphics 41(4).
- Rusu, A. A. et al. (2016). Policy distillation. ICLR.
作業ログ
| 作業ログ | ラン | 時間 | コスト |
|---|---|---|---|
| 生徒:ネットワークサイズの実験2026年10月31日 · 動作を変えずに2 × 512から1024 × 2、512 × 3、1024 × 3へ拡張した生徒を、512 × 2の対照と並べてそれぞれ200 Mステップ学習させました。教師との距離、ゲート、そして4台のマシン。 | 4 | 14 | $7.65 |
| 合計 | 4 | 14 | $7.65 |